Quando si parla di intelligenza artificiale, chi sviluppa in PHP ha spesso l’impressione che la conversazione riguardi qualcun altro. Gli esempi sono in Python, i tutorial partono dalla matematica, gli strumenti presuppongono notebook e GPU. Nelle prime due parti di questa serie abbiamo già visto che non è così: abbiamo riconosciuto entità nei testi e costruito un assistente basato sui documenti.
In questa terza parte facciamo un passo indietro per fissare alcuni concetti e poi costruiamo, interamente in PHP, un modello di machine learning “classico”: uno di quelli che non generano testo, ma imparano dai dati storici a fare previsioni. È il tipo di intelligenza artificiale che risolve più problemi concreti nelle applicazioni gestionali, ed è anche quello di cui si parla meno.
Intelligenza artificiale non è (solo) data science
Il primo equivoco da sciogliere è l’idea che “fare AI” significhi addestrare reti neurali enormi. Nella pratica di chi sviluppa applicazioni, il lavoro si divide in modo diverso:
- Addestramento (training): costruire un modello a partire dai dati. Per i grandi modelli linguistici richiede risorse enormi e competenze specialistiche. Per un modello su dati tabellari bastano un file CSV e pochi secondi di CPU.
- Inferenza: usare un modello già addestrato per ottenere una previsione. È veloce, si ripete a ogni richiesta e si integra perfettamente in un’applicazione web.
- Integrazione: decidere dove il modello entra nel flusso applicativo, come si gestiscono gli errori, come si misura se sta funzionando. È la parte in cui chi sviluppa in PHP ha più da dare.
Allo stesso modo, non tutti i problemi di “AI” richiedono un modello linguistico. Molti si riconducono a poche famiglie:
| Tipo di problema | Domanda | Esempi |
|---|---|---|
| Classificazione | A quale categoria appartiene? | disdetta sì/no, ticket urgente o no, transazione sospetta |
| Regressione | Quale valore numerico? | tempo di consegna, consumo previsto, prezzo stimato |
| Clustering | Quali elementi si somigliano? | segmenti di clientela, gruppi di documenti |
| Similarità | Cosa è più vicino a questo? | prodotti correlati, documenti simili, ricerca semantica |
| Anomalie | Cosa è fuori dall’ordinario? | accessi sospetti, letture anomale di un sensore |
Per tutti questi casi esistono algoritmi consolidati, che girano bene anche in PHP. La libreria di riferimento è Rubix ML: open source, scritta in PHP, con decine di algoritmi, trasformazioni dei dati, metriche di valutazione e salvataggio dei modelli. Gli esempi che seguono usano la versione 2.5.
Il caso: chi sta per disdire?
Immaginiamo un servizio in abbonamento. Ogni mese una parte degli abbonati disdice, e trattenere un cliente costa molto meno che acquisirne uno nuovo. Se sapessimo in anticipo chi è a rischio, potremmo contattarlo prima: un’offerta, una telefonata, un aiuto con un problema rimasto aperto.
Abbiamo uno storico di 1.200 abbonati, per ciascuno dei quali conosciamo alcune informazioni e l’esito finale (ha disdetto oppure no):
mesi,accessi_30g,ticket_90g,piano,pagamento,disdetta
41,30,0,base,carta,no
35,28,0,base,carta,no
33,7,1,plus,carta,si
...
Le colonne sono l’anzianità in mesi, gli accessi al servizio negli ultimi 30 giorni, i ticket di assistenza aperti negli ultimi 90, il piano sottoscritto e il metodo di pagamento. I dati dell’esempio sono sintetici, generati con relazioni plausibili e una buona dose di rumore casuale: come nella realtà, nessuna regola semplice separa perfettamente chi resta da chi se ne va.
Installazione
composer require rubix/ml
Rubix ML funziona in PHP puro. È disponibile anche un’estensione opzionale che accelera i calcoli matriciali, utile con dataset grandi ma non necessaria per un caso come questo.
Il ciclo di vita di un modello
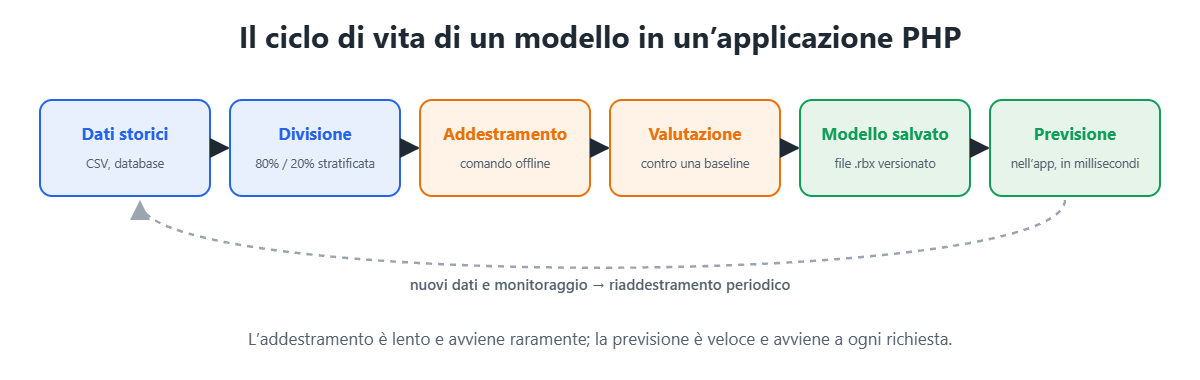
Prima del codice conviene fissare il flusso. Il modello si addestra offline, con un comando da console o un job pianificato, su dati storici. Si valuta su una parte dei dati che non ha mai visto. Se il risultato è soddisfacente, si salva su file. L’applicazione carica quel file e lo usa per le previsioni, che richiedono pochi millisecondi. Periodicamente, con nuovi dati, si riaddestra.
Addestramento e valutazione
<?php

declare(strict_types=1);

require __DIR__ . '/vendor/autoload.php';

use Rubix\ML\Classifiers\ClassificationTree;
use Rubix\ML\Classifiers\RandomForest;
use Rubix\ML\CrossValidation\Metrics\Accuracy;
use Rubix\ML\CrossValidation\Reports\ConfusionMatrix;
use Rubix\ML\CrossValidation\Reports\MulticlassBreakdown;
use Rubix\ML\Datasets\Labeled;
use Rubix\ML\Extractors\CSV;
use Rubix\ML\Persisters\Filesystem;
use Rubix\ML\PersistentModel;
use Rubix\ML\Pipeline;
use Rubix\ML\Transformers\NumericStringConverter;

// 1. Caricamento: il CSV restituisce stringhe, le colonne numeriche vanno convertite
$dataset = Labeled::fromIterator(new CSV(__DIR__ . '/abbonati.csv', true))
    ->apply(new NumericStringConverter());

// 2. Divisione stratificata: 80% per addestrare, 20% per verificare
[$addestramento, $verifica] = $dataset->randomize()->stratifiedSplit(0.8);

// 3. Modello: una foresta di alberi decisionali
$stimatore = new Pipeline([], new RandomForest(new ClassificationTree(6), 200));
$stimatore->train($addestramento);

// 4. Valutazione su dati mai visti durante l'addestramento
$previsioni = $stimatore->predict($verifica);

$accuratezza = (new Accuracy())->score($previsioni, $verifica->labels());
printf("Accuratezza: %.1f%%\n", $accuratezza * 100);

$matrice = (new ConfusionMatrix())->generate($previsioni, $verifica->labels());
echo json_encode($matrice, JSON_PRETTY_PRINT), PHP_EOL;

$dettaglio = (new MulticlassBreakdown())->generate($previsioni, $verifica->labels());
printf("Precisione sulle disdette: %.2f · Richiamo: %.2f\n",
    $dettaglio['classes']['si']['precision'], $dettaglio['classes']['si']['recall']);

// 5. Salvataggio del modello addestrato
$modello = new PersistentModel($stimatore, new Filesystem(__DIR__ . '/var/disdette.rbx'));
$modello->save();
Vediamo le scelte una per una.
La conversione dei tipi. Il lettore CSV restituisce tutto come stringa; NumericStringConverter trasforma in numeri le colonne numeriche. Le colonne testuali, come il piano e il metodo di pagamento, restano categorie: gli alberi decisionali di Rubix ML le gestiscono direttamente.
La divisione stratificata. Valutare un modello sugli stessi dati con cui è stato addestrato è come correggere un compito avendo dato agli studenti le soluzioni: il risultato è ottimo e non significa nulla. Per questo il 20% degli abbonati viene tenuto da parte. “Stratificata” significa che la proporzione tra disdette e non disdette resta la stessa in entrambe le parti.
Il modello. Un random forest combina 200 alberi decisionali, ciascuno addestrato su una parte diversa dei dati, e li fa “votare”. È una scelta robusta per dati tabellari: funziona bene senza molte regolazioni, gestisce variabili numeriche e categoriche e soffre poco l’overfitting, cioè la tendenza a imparare a memoria i dati di addestramento invece delle regole generali. La profondità massima di ogni albero (6) è un’ulteriore protezione in questo senso.
La pipeline. Qui è vuota, ma è il posto in cui inserire eventuali trasformazioni dei dati (normalizzazioni, codifiche). Racchiuderle nella pipeline garantisce che vengano applicate allo stesso modo durante l’addestramento e durante le previsioni: è uno degli errori più comuni dimenticarsene in produzione.
Leggere i risultati
Questo è il risultato di un’esecuzione reale:
Accuratezza: 70.0%
Precisione sulle disdette: 0.66 · Richiamo: 0.54
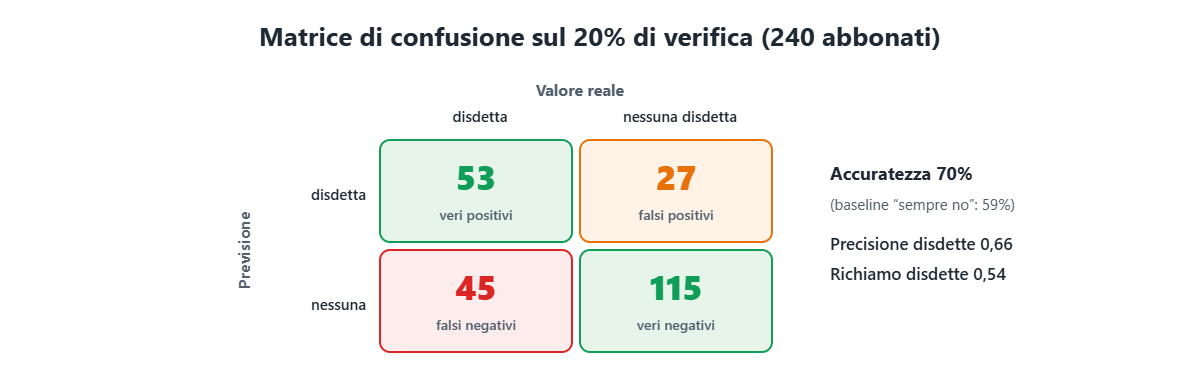
Il 70% di accuratezza può sembrare poco, ma un numero non dice nulla da solo: va confrontato con una baseline. Nel campione di verifica il 59% degli abbonati non ha disdetto, quindi un “modello” che rispondesse sempre “nessuna disdetta” avrebbe un’accuratezza del 59% e non servirebbe a niente. Il nostro modello fa meglio, e soprattutto individua concretamente una parte delle disdette.
La matrice di confusione racconta il resto. Su 98 disdette reali, il modello ne ha previste correttamente 53: è il richiamo (0,54). Su 80 abbonati che ha segnalato come a rischio, 53 lo erano davvero: è la precisione (0,66). I 27 falsi positivi sono clienti contattati senza necessità; i 45 falsi negativi sono disdette che non abbiamo visto arrivare.
Quale errore pesa di più dipende dal contesto, non dalla tecnica. Se contattare un cliente costa poco (un’email), conviene segnalare di più accettando qualche falso positivo. Se ogni contatto è una telefonata di un commerciale, conviene essere selettivi. Lo strumento per scegliere è la soglia di probabilità, che vediamo tra poco.
Usare il modello nell’applicazione
Nell’applicazione il modello si carica dal file e si interroga. Invece della sola etichetta conviene chiedere la probabilità, che permette di ordinare i clienti per rischio e di scegliere la soglia più adatta:
<?php

declare(strict_types=1);

require __DIR__ . '/vendor/autoload.php';

use Rubix\ML\Datasets\Unlabeled;
use Rubix\ML\Persisters\Filesystem;
use Rubix\ML\PersistentModel;

$modello = PersistentModel::load(new Filesystem(__DIR__ . '/var/disdette.rbx'));

// abbonati attivi: mesi, accessi negli ultimi 30 giorni, ticket negli ultimi 90, piano, pagamento
$abbonati = [
    'A-1001' => [3, 2, 4, 'base', 'bonifico'],
    'A-1002' => [36, 25, 0, 'pro', 'carta'],
    'A-1003' => [12, 9, 2, 'plus', 'carta'],
];

$probabilita = $modello->proba(new Unlabeled(array_values($abbonati)));

foreach (array_keys($abbonati) as $i => $codice) {
    printf("%s  rischio di disdetta: %3.0f%%\n", $codice, $probabilita[$i]['si'] * 100);
}
A-1001  rischio di disdetta:  90%
A-1002  rischio di disdetta:  12%
A-1003  rischio di disdetta:  66%
L’ordine delle colonne deve essere identico a quello usato in addestramento: è un contratto implicito tra il comando che addestra e il codice che prevede. In un progetto reale conviene renderlo esplicito con una piccola classe che costruisce il vettore di input a partire dall’entità Abbonato, usata in entrambi i punti.
Capire che cosa ha imparato
Il random forest di Rubix ML può restituire l’importanza delle variabili, una misura di quanto ciascuna colonna contribuisce alle decisioni:
$foresta = $modello->base()->base(); // PersistentModel → Pipeline → RandomForest
$nomi = ['mesi', 'accessi_30g', 'ticket_90g', 'piano', 'pagamento'];

$importanze = $foresta->featureImportances();
arsort($importanze);

foreach ($importanze as $indice => $valore) {
    printf("%-12s %.3f\n", $nomi[$indice], $valore);
}
Nel nostro caso le variabili più rilevanti risultano l’anzianità, gli accessi recenti e i ticket aperti, seguite da piano e metodo di pagamento. È coerente con l’intuizione, ed è proprio questo il punto: un modello di cui si capiscono le ragioni è un modello di cui ci si può fidare (o diffidare) con cognizione di causa. Una cautela: questo tipo di misura tende a sopravvalutare le variabili numeriche con molti valori distinti rispetto a quelle con poche categorie, quindi va letta come un’indicazione e non come una classifica esatta.
Dalla demo alla produzione
- Addestramento separato dalle richieste web. Un comando da console (o un job pianificato) addestra, valuta e salva. Se la valutazione peggiora rispetto al modello in uso, il nuovo modello non viene pubblicato.
- Versionamento. Ogni file di modello va associato ai dati e al codice con cui è stato prodotto, così da poter riprodurre e confrontare i risultati.
- Deriva dei dati. I comportamenti cambiano: un modello addestrato un anno fa può perdere precisione senza che nessuno se ne accorga. Conviene monitorare nel tempo le previsioni rispetto agli esiti reali e riaddestrare a cadenza regolare.
- Qualità dei dati. Valori mancanti, errori di inserimento e colonne che “anticipano” l’esito (ad esempio una data di chiusura del contratto) producono modelli che sembrano eccellenti in prova e falliscono in produzione.
- Profilazione e dati personali. Stimare il rischio di disdetta di una persona è una forma di profilazione. Prima di metterla in produzione va valutata sotto il profilo della protezione dei dati: base giuridica, informativa, diritto di opposizione e, se dal punteggio derivano decisioni con effetti significativi per l’interessato, le garanzie previste per i processi decisionali automatizzati.
Quando PHP basta e quando no
PHP con Rubix ML è perfettamente adeguato per dataset fino a qualche centinaio di migliaia di righe, per i modelli classici (alberi, foreste, regressioni, k-NN, Naive Bayes, clustering) e per tutti i casi in cui la previsione deve vivere dentro l’applicazione. Diventa stretto con reti neurali profonde, immagini e audio, o con volumi di dati molto grandi: lì l’ecosistema Python resta più attrezzato, e la strada giusta è usarlo come servizio affiancato, come nella prima parte della serie.
Conclusione
Fare machine learning in PHP non richiede di diventare data scientist. Richiede però alcune abitudini: tenere separati i dati di verifica, confrontarsi sempre con una baseline, scegliere la metrica in base al costo degli errori e trattare il modello come un componente da versionare e monitorare. Il codice, come si è visto, è la parte breve.
Nella prossima parte entreremo nel mondo dei modelli neurali pre-addestrati, eseguendoli direttamente dentro PHP grazie a TransformersPHP: classificazione del testo, analisi del sentiment e ricerca semantica senza servizi esterni.
Serie “PHP e intelligenza artificiale” – parte 3 di 8.
← Parte precedente: Un assistente che risponde con i tuoi documenti (RAG)
Parte successiva: Modelli neurali dentro PHP con TransformersPHP →