
Un’applicazione SaaS serve molti clienti con la stessa infrastruttura: è il modello multi-tenant. Funziona benissimo finché i clienti si comportano più o meno allo stesso modo. Poi arriva il lunedì mattina in cui un cliente importa un catalogo da centinaia di migliaia di prodotti, la coda dei lavori asincroni si riempie e tutti gli altri iniziano a scrivere all’assistenza: le email di conferma non arrivano, i report non si generano, le esportazioni restano “in elaborazione”.
È il problema del vicino rumoroso (noisy neighbour): un cliente che consuma molte risorse peggiora il servizio di tutti gli altri. In questo articolo lo misuriamo con una simulazione, confrontiamo le strategie per risolverlo e ne implementiamo due con Symfony Messenger e il componente RateLimiter, con codice collaudato.
Che cosa vuol dire “equo”
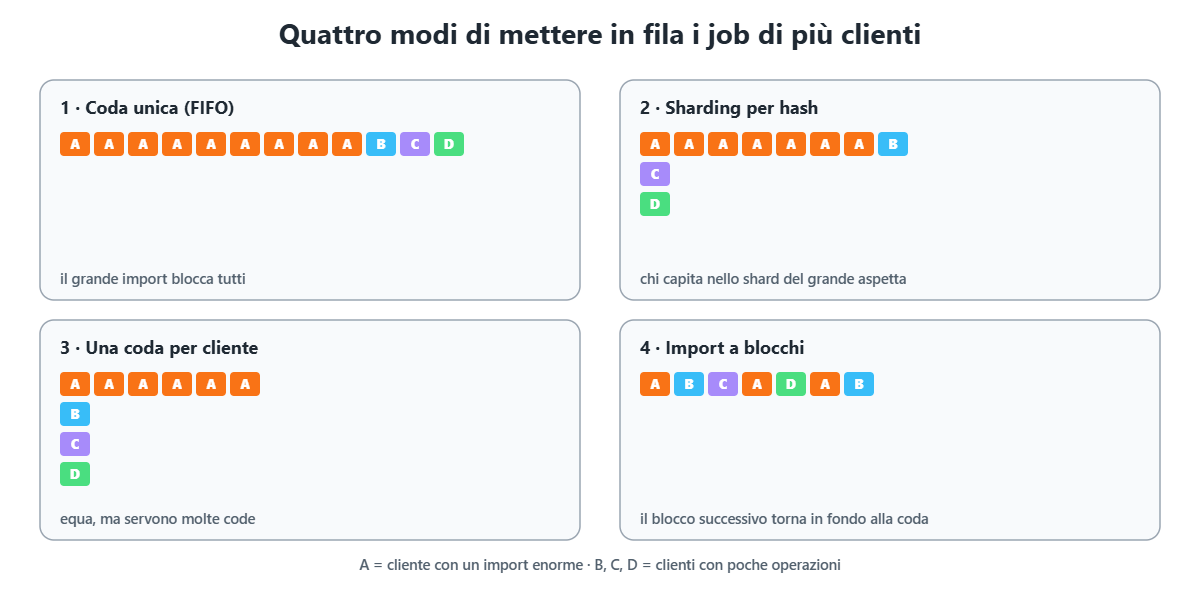
Una coda tradizionale è FIFO: il primo che entra è il primo che esce. È equa verso i messaggi, non verso i clienti. Se un cliente accoda tremila lavori e un altro ne accoda uno subito dopo, il secondo aspetta che finiscano tutti i tremila.
In un sistema multi-tenant l’equità che conta è un’altra: nessun cliente deve poter ritardare gli altri oltre una misura ragionevole, indipendentemente da quanto lavoro produce. Ci sono poi regole commerciali: un cliente con un piano superiore può avere diritto a più risorse, ma neanche lui dovrebbe poter bloccare chi paga meno.
Il problema in numeri
Per capire quanto pesa il problema, e quanto aiutano le diverse soluzioni, abbiamo scritto una piccola simulazione in PHP. Lo scenario è questo:
- un pool di 4 worker, ciascuno impiega 50 millisecondi per job (80 job al secondo in totale);
- all’istante zero un cliente “grande” accoda un import da 3.000 elementi;
- tre clienti “piccoli” accodano 30 job ciascuno, distribuiti a caso nei primi 30 secondi: azioni normali degli utenti, come l’invio di un’email o la generazione di un PDF.
Misuriamo quanto aspettano i job dei clienti piccoli prima di essere elaborati, e quando finisce l’import del cliente grande. Il nucleo della simulazione è un ciclo che assegna il prossimo job al primo worker libero, scegliendo la coda secondo una strategia intercambiabile:
/**
 * @param callable(array $job): string $instrada restituisce la coda in cui inserire un job
 * @param callable(array $code, float $ora): ?string $scegliCoda restituisce la coda da cui prelevare
 * @return array<string, list<float>> attese per tenant
 */
function simula(callable $instrada, callable $scegliCoda): array
{
    $carico = generaCarico();
    $code = [];
    $attese = [];
    $liberi = array_fill(0, WORKER, 0.0); // istante in cui ogni worker torna libero
    $i = 0;
    $ora = 0.0;

    while ($i < count($carico) || array_sum(array_map('count', $code)) > 0) {
        asort($liberi);
        $w = array_key_first($liberi);   // il prossimo worker libero
        $ora = max($ora, $liberi[$w]);

        while ($i < count($carico) && $carico[$i]['arrivo'] <= $ora) {
            $code[$instrada($carico[$i])][] = $carico[$i];   // accoda ciò che è arrivato
            $i++;
        }

        $coda = $scegliCoda($code, $ora);
        if ($coda === null) {            // nessun job pronto: si salta al prossimo arrivo
            $ora = $carico[$i]['arrivo'];
            continue;
        }

        $job = array_shift($code[$coda]);
        $attese[$job['tenant']][] = $ora - $job['arrivo'];
        $liberi[$w] = $ora + DURATA;
    }

    return $attese;
}
Ecco i risultati per le prime tre strategie:
| Strategia | Attesa clienti piccoli (mediana) | Attesa clienti piccoli (95° percentile) | Fine import grande |
|---|---|---|---|
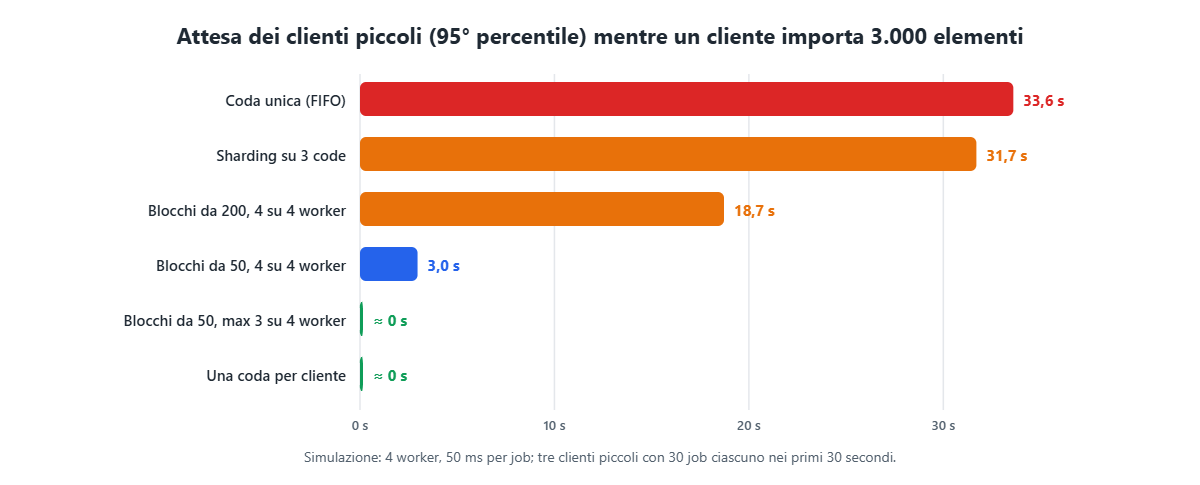
| Coda unica (FIFO) | 22,4 s | 33,6 s | 37,5 s |
| Sharding su 3 code per hash del cliente | 0 s | 31,7 s | 38,2 s |
| Una coda per cliente, prelievo a turno | 0 s | 0 s | 38,6 s |
Con la coda unica, un’azione che dovrebbe richiedere 50 millisecondi ne richiede in media più di 22 secondi. La coda per cliente risolve completamente il problema, e il cliente grande paga appena un secondo in più. Lo sharding merita un discorso a parte, perché il dato aggregato nasconde l’essenziale: dei tre clienti piccoli, due non hanno atteso nulla, mentre il terzo, che l’hash aveva assegnato alla stessa coda del cliente grande, ha atteso come con la coda unica.
Le strategie, una per una
Aggiungere worker
È la prima reazione, e non risolve il problema: lo sposta. Più worker smaltiscono prima il picco, ma finché la coda è unica i job dei clienti piccoli restano comunque in fila dietro a quelli del grande, e il costo dell’infrastruttura cresce in funzione del cliente più esigente.
Sharding
Si distribuiscono i clienti su un numero fisso di code, ad esempio in base all’hash del loro identificativo, e i worker prelevano a turno da tutte. Riduce l’impatto di un cliente rumoroso a una frazione dei clienti, ma la simulazione mostra il limite: per chi capita nella stessa coda del cliente pesante non cambia nulla. È una lotteria. Una variante utile è la coda di sfogo: quando un cliente supera una certa soglia, i suoi job vengono spostati in una coda dedicata, con meno worker.
Una coda per cliente
È la soluzione più equa: i worker prelevano a turno da ogni coda, e ogni cliente ottiene la sua quota indipendentemente dal volume degli altri. Il prezzo è operativo: con centinaia o migliaia di clienti servono centinaia o migliaia di code, che vanno create, monitorate e consumate. Alcuni broker e servizi gestiti pongono limiti al numero di code, e i worker di Symfony Messenger si avviano su un elenco di transport noto in anticipo, non su un numero di code che cresce con i clienti.
Cambiare che cosa si mette in coda
Spesso la soluzione migliore non sta nella coda, ma nei messaggi. Il problema nasce dall’accodare tremila job in un colpo solo. Se invece l’import diventa un unico messaggio che elabora un blocco di elementi e poi rimette in coda il blocco successivo, il cliente grande non occupa mai più di pochi posti nella coda. Tra un blocco e l’altro passano i job degli altri clienti. Abbiamo simulato anche questa variante, facendo variare la dimensione dei blocchi e il numero di blocchi dello stesso import che possono essere in coda contemporaneamente:
| Blocchi in parallelo | Elementi per blocco | Attesa clienti piccoli (mediana / 95° percentile) | Fine import grande |
|---|---|---|---|
| 1 su 4 worker | 50 | 0 s / 0 s | 150,0 s |
| 2 su 4 worker | 50 | 0 s / 0 s | 75,0 s |
| 3 su 4 worker | 50 | 0 s / 0,03 s | 50,0 s |
| 4 su 4 worker | 20 | 0,5 s / 1,0 s | 38,7 s |
| 4 su 4 worker | 50 | 1,3 s / 3,0 s | 38,9 s |
| 4 su 4 worker | 200 | 12,1 s / 18,7 s | 41,3 s |
La tabella mostra le due manopole di questa strategia. Il numero di blocchi in parallelo è in pratica un limite di concorrenza per cliente: se non può mai occupare tutti i worker, gli altri trovano sempre un worker libero, a costo di allungare l’import. La dimensione del blocco stabilisce quanto aspetta, nel caso peggiore, chi arriva mentre tutti i worker sono occupati: blocchi piccoli rendono il sistema reattivo, blocchi grandi riducono il numero di messaggi ma reintroducono le attese.
Limitare la velocità per cliente
La strategia complementare è il rate limiting per cliente: ogni cliente può far elaborare al massimo un certo numero di messaggi per unità di tempo; oltre quella soglia i suoi messaggi vengono rimandati di qualche istante. È il modo naturale di tradurre in codice i piani commerciali (il piano “pro” ha una quota più alta del “base”) e di rispettare i limiti di API esterne, che spesso sono a loro volta per account.
L’implementazione con Symfony Messenger
Mettiamo insieme le ultime due strategie in un’applicazione Symfony (gli esempi sono compatibili con Symfony 7.4 e 8.x). Il primo passo è rendere esplicito, in ogni messaggio, a quale cliente appartiene:
namespace App\Messenger;

interface MessaggioDelTenant
{
    public function tenantId(): string;
}

/** Elabora un blocco di righe di un import e, se ne restano, accoda il blocco successivo. */
final readonly class ImportaBlocco implements MessaggioDelTenant
{
    public function __construct(
        public string $tenant,
        public string $importId,
        public int $offset = 0,
    ) {
    }

    public function tenantId(): string
    {
        return $this->tenant;
    }
}
L’import a blocchi
Il gestore legge un blocco di righe, le elabora e, se il blocco era pieno, accoda il successivo. Il nuovo messaggio finisce in fondo alla coda, dietro ai job che nel frattempo sono arrivati dagli altri clienti:
namespace App\Messenger;

use Symfony\Component\Messenger\Attribute\AsMessageHandler;
use Symfony\Component\Messenger\MessageBusInterface;

#[AsMessageHandler]
final readonly class ImportaBloccoHandler
{
    public function __construct(
        private SorgenteImport $sorgente,
        private ElaboratoreRiga $elaboratore,
        private MessageBusInterface $bus,
        private int $dimensioneBlocco = 50,
    ) {
    }

    public function __invoke(ImportaBlocco $messaggio): void
    {
        $righe = $this->sorgente->righe($messaggio->importId, $messaggio->offset, $this->dimensioneBlocco);

        foreach ($righe as $riga) {
            $this->elaboratore->elabora($messaggio->tenantId(), $riga);
        }

        if (count($righe) === $this->dimensioneBlocco) {
            // il blocco successivo va in fondo alla coda: nel frattempo passano i job degli altri tenant
            $this->bus->dispatch(new ImportaBlocco($messaggio->tenant, $messaggio->importId, $messaggio->offset + $this->dimensioneBlocco));
        }
    }
}
Nel collaudo, un import da 120 righe con blocchi da 50 è stato elaborato con tre messaggi successivi (50, 50 e 20 righe). Per ottenere più blocchi in parallelo, e quindi un import più rapido, basta far partire l’import con due o tre messaggi su intervalli di righe distinti: il loro numero è il limite di concorrenza di cui abbiamo parlato.
Un limite di velocità per cliente e per piano
Il limite si applica con un middleware di Messenger, che intercetta ogni messaggio prima che arrivi al gestore. Usiamo il componente RateLimiter di Symfony con un limitatore per ogni piano commerciale; la chiave del limitatore è l’identificativo del cliente, quindi ogni cliente ha la propria quota:
namespace App\Messenger;

use Symfony\Component\Messenger\Envelope;
use Symfony\Component\Messenger\Exception\RecoverableMessageHandlingException;
use Symfony\Component\Messenger\Middleware\MiddlewareInterface;
use Symfony\Component\Messenger\Middleware\StackInterface;
use Symfony\Component\Messenger\Stamp\ReceivedStamp;
use Symfony\Component\RateLimiter\RateLimiterFactory;

final readonly class LimitePerTenantMiddleware implements MiddlewareInterface
{
    /** @param array<string, RateLimiterFactory> $limitatoriPerPiano */
    public function __construct(
        private array $limitatoriPerPiano,
        private PianoTenant $piani,
    ) {
    }

    public function handle(Envelope $envelope, StackInterface $stack): Envelope
    {
        $messaggio = $envelope->getMessage();

        // si limita solo quando il worker riceve il messaggio, non quando lo si invia
        if (!$messaggio instanceof MessaggioDelTenant || $envelope->last(ReceivedStamp::class) === null) {
            return $stack->next()->handle($envelope, $stack);
        }

        $tenant = $messaggio->tenantId();
        $limite = $this->limitatoriPerPiano[$this->piani->piano($tenant)]->create($tenant)->consume();

        if (!$limite->isAccepted()) {
            // quota esaurita: Messenger rimette il messaggio in coda dopo il ritardo indicato
            $attesaMs = max(1, (int) ceil(((float) $limite->getRetryAfter()->format('U.u') - microtime(true)) * 1000));

            throw new RecoverableMessageHandlingException("Quota esaurita per il tenant $tenant", retryDelay: $attesaMs);
        }

        return $stack->next()->handle($envelope, $stack);
    }
}
Il dettaglio più importante è come il messaggio torna in coda. Una prima idea sarebbe iniettare il bus nel middleware e rispedire il messaggio con un ritardo; ma il middleware fa parte dello stesso bus, e il container segnalerebbe una dipendenza circolare. La soluzione più pulita è lanciare una RecoverableMessageHandlingException: Messenger ritenta sempre i messaggi che falliscono con un’eccezione “recuperabile”, e da Symfony 7.2 l’eccezione può indicare dopo quanti millisecondi ritentare. Il worker, intanto, passa al messaggio successivo, che appartiene con buona probabilità a un altro cliente.
La configurazione dichiara i limitatori, registra il middleware sul bus e gli passa i limitatori per piano:
# config/packages/rate_limiter.yaml
framework:
    rate_limiter:
        tenant_base:
            policy: token_bucket
            limit: 20                                 # raffica massima
            rate: { interval: '1 second', amount: 5 } # ritmo sostenibile
        tenant_pro:
            policy: token_bucket
            limit: 100
            rate: { interval: '1 second', amount: 25 }

# config/packages/messenger.yaml
framework:
    messenger:
        buses:
            messenger.bus.default:
                middleware:
                    - App\Messenger\LimitePerTenantMiddleware

# config/services.yaml
services:
    App\Messenger\LimitePerTenantMiddleware:
        arguments:
            $limitatoriPerPiano:
                base: '@limiter.tenant_base'
                pro: '@limiter.tenant_pro'
Nel collaudo, con un limite di 3 messaggi consecutivi per il piano base e di 10 per il piano pro, cinque messaggi ravvicinati di un cliente base sono stati elaborati tre volte e rimandati due, con un ritardo di poco meno di due secondi; i cinque messaggi del cliente pro sono stati elaborati tutti. L’algoritmo token bucket è adatto a questo uso: consente brevi raffiche fino a limit e poi un ritmo costante pari a rate.
Le priorità
Un’ultima leva, semplice ed efficace, è separare i messaggi per urgenza. Le azioni che un utente aspetta davanti allo schermo (una notifica, la generazione di un documento) vanno in un transport prioritario; i lavori massivi in uno normale. Quando un worker riceve più transport, Messenger li interroga nell’ordine indicato e passa al secondo solo quando il primo è vuoto:
# config/packages/messenger.yaml (estratto, transport Doctrine)
framework:
    messenger:
        transports:
            async_priorita: 'doctrine://default?queue_name=priorita'
            async: 'doctrine://default?queue_name=normale'
        routing:
            App\Messenger\GeneraDocumento: async_priorita
            App\Messenger\ImportaBlocco: async
php bin/console messenger:consume async_priorita async
Le priorità proteggono i flussi interattivi, ma da sole non risolvono il problema dell’equità tra clienti: se il cliente grande produce anche messaggi prioritari, monopolizza quelli. Vanno quindi combinate con le altre strategie.
Dettagli che fanno la differenza in produzione
- Archivio condiviso per i limitatori. Con più worker su più macchine, lo stato dei limitatori deve stare in un archivio comune (ad esempio Redis), altrimenti ogni macchina applica il limite per conto proprio.
- Supporto ai ritardi. Ritardare un messaggio richiede un transport che lo supporti: Doctrine, Redis e AMQP lo fanno.
- Idempotenza. La consegna è “almeno una volta”: se un worker si interrompe a metà di un blocco, il blocco verrà rielaborato. L’elaborazione di ogni riga deve poter essere ripetuta senza effetti doppi, ad esempio con un aggiornamento per codice prodotto invece di un inserimento.
- Metriche per cliente. Il numero di messaggi in coda per transport non basta: servono attese e volumi per cliente, che sono l’unico modo di accorgersi di un vicino rumoroso prima che lo facciano gli altri clienti.
- Limiti esterni. Se i job chiamano API di terze parti con quote per account, il limitatore può usare quelle stesse quote, magari leggendo gli header di risposta che indicano quante chiamate restano.
Quale strategia scegliere
| Situazione | Strategia consigliata |
|---|---|
| Pochi clienti, carichi simili | Coda unica, eventualmente con transport prioritario per le azioni interattive |
| Pochi clienti molto grandi e noti | Una coda (o un pool di worker) dedicata per ciascuno |
| Molti clienti, volumi molto diversi | Import a blocchi con limite di concorrenza, più rate limiting per cliente |
| Piani commerciali con risorse diverse | Rate limiting per piano, eventualmente pool di worker separati per i piani più alti |
| Picchi improvvisi e imprevedibili | Coda di sfogo per i clienti che superano una soglia |
Conclusione
In un sistema multi-tenant la domanda giusta non è “quanto lavoro riesco a smaltire”, ma “quanto può aspettare un cliente a causa di un altro”. La simulazione mostra che la differenza tra le strategie è enorme: da più di venti secondi di attesa media a praticamente zero, a parità di worker. E la soluzione più efficace è spesso anche la più semplice: cambiare la granularità di ciò che si mette in coda e dare a ogni cliente una quota. Con Symfony Messenger servono un messaggio che si rimette in coda, un middleware e qualche riga di configurazione.
