Nella parte precedente abbiamo addestrato in PHP un modello di machine learning classico, partendo da dati tabellari. Per i testi, le immagini e l’audio, però, i modelli più efficaci oggi sono le reti neurali pre-addestrate: modelli che qualcun altro ha già allenato su enormi quantità di dati e che noi possiamo semplicemente usare.
Di solito questo significa chiamare un’API esterna o affiancare un servizio Python, come abbiamo fatto nella prima parte. Esiste però una terza strada: eseguire il modello direttamente dentro il processo PHP. È quello che permette TransformersPHP, una libreria open source che porta in PHP l’interfaccia resa popolare dalla libreria Transformers di Hugging Face. In questo articolo la mettiamo alla prova su un caso concreto, con risultati e misure reali, compresi quelli che non sono andati come previsto. Gli esempi usano la versione 0.6 della libreria.
Come funziona
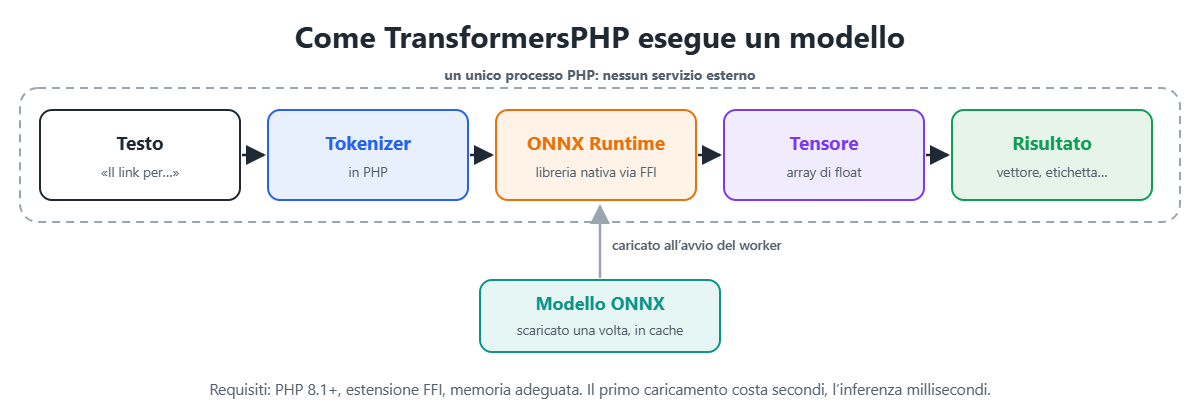
I modelli sono distribuiti nel formato ONNX, uno standard aperto per rappresentare reti neurali indipendentemente dal framework con cui sono state addestrate. Molti modelli popolari esistono già convertiti in ONNX e spesso quantizzati, cioè con i pesi ridotti a una precisione inferiore: occupano molto meno spazio e girano più velocemente, con una perdita di qualità di solito modesta.
L’esecuzione è affidata a ONNX Runtime, una libreria nativa ad alte prestazioni, che PHP richiama attraverso FFI (Foreign Function Interface), il meccanismo che permette di chiamare funzioni scritte in C. La preparazione del testo (la tokenizzazione, cioè la scomposizione in unità che il modello comprende) e l’interpretazione dei risultati avvengono invece in PHP. Tutto succede nello stesso processo: nessun servizio esterno, nessuna chiamata di rete dopo il primo download del modello.
Requisiti e installazione
- PHP 8.1 o superiore con l’estensione FFI abilitata.
- Memoria: i modelli vengono caricati in RAM. Per i modelli piccoli bastano poche centinaia di megabyte, per quelli più grandi serve molto di più.
- Piattaforma: le librerie native vengono installate automaticamente per Linux (x86_64 e ARM64) e macOS su Apple Silicon.
composer require codewithkyrian/transformers
C’è un dettaglio di configurazione che conviene conoscere subito. Per impostazione predefinita la direttiva ffi.enable vale preload: FFI è utilizzabile dalla riga di comando e nei file caricati con il preloading, ma non nel codice eseguito normalmente da PHP-FPM. Abilitarla ovunque (ffi.enable=true) funziona, ma amplia la superficie d’attacco, perché FFI permette di chiamare qualunque funzione nativa. Come vedremo, l’architettura più sensata non ha bisogno di FFI nelle richieste web.
I modelli vengono scaricati da Hugging Face al primo utilizzo. In produzione conviene scaricarli in anticipo, ad esempio durante la build dell’immagine, con il comando incluso nella libreria:
./vendor/bin/transformers download Xenova/paraphrase-multilingual-MiniLM-L12-v2 embeddings
Che cosa si può fare
L’accesso ai modelli passa da un’unica funzione, pipeline(), che riceve il tipo di compito e, facoltativamente, il nome del modello. Tra i compiti supportati:
| Compito | Identificativo | Uso tipico |
|---|---|---|
| Embeddings | embeddings |
ricerca semantica, similarità, raggruppamento |
| Classificazione del testo | text-classification |
sentiment, categorie, moderazione |
| Classificazione zero-shot | zero-shot-classification |
categorie decise al momento, senza addestramento |
| Riconoscimento di entità | ner |
persone, luoghi, organizzazioni |
| Domanda e risposta | question-answering |
estrarre una risposta da un testo |
| Riassunto e traduzione | summarization, translation |
testi brevi |
| Immagini | image-classification, object-detection… |
classificare e individuare oggetti |
| Audio | automatic-speech-recognition |
trascrizione |
Un’avvertenza che vale per tutta la libreria: se non si indica un modello, viene usato quello predefinito per il compito, che quasi sempre è addestrato solo in inglese. Per testi italiani bisogna scegliere esplicitamente un modello multilingue o italiano.
Il caso: smistare i ticket di assistenza
Un servizio clienti riceve ogni giorno decine di messaggi che vanno indirizzati alla coda giusta: problemi di accesso, questioni di fatturazione, richieste commerciali. Vogliamo automatizzare lo smistamento senza mandare i messaggi dei clienti a servizi esterni.
Primo tentativo: classificazione zero-shot
La classificazione zero-shot sembra la soluzione perfetta: si passano al modello il testo e l’elenco delle categorie, senza alcun addestramento. Usiamo un modello multilingue addestrato per questo compito:
use Codewithkyrian\Transformers\Transformers;

use function Codewithkyrian\Transformers\Pipelines\pipeline;

Transformers::setup()->setCacheDir(__DIR__ . '/models')->apply();

$classificatore = pipeline('zero-shot-classification', 'Xenova/mDeBERTa-v3-base-xnli-multilingual-nli-2mil7');

$esito = $classificatore(
    'Mi avete addebitato due volte l’abbonamento di marzo',
    ['accesso e credenziali', 'fatturazione e pagamenti', 'informazioni commerciali'],
    hypothesisTemplate: 'Questo messaggio riguarda {}.',
);

echo $esito['labels'][0], ' ', round($esito['scores'][0], 2), PHP_EOL;
Il risultato, su tre messaggi di prova, è stato deludente: una sola categoria corretta su tre, con punteggi tutti intorno a 0,45, cioè con il modello sostanzialmente incerto. Il doppio addebito è finito tra le “informazioni commerciali”, la domanda sul piano Pro tra i “pagamenti”. È un risultato da tenere a mente: la classificazione zero-shot è affascinante, ma con modelli piccoli e quantizzati, su una lingua diversa dall’inglese, l’affidabilità può essere molto bassa. Va sempre misurata prima di fidarsi.
Secondo tentativo: pochi esempi e similarità
Cambiamo approccio. Invece di chiedere al modello di “capire” le categorie, gli chiediamo una cosa che fa molto meglio: trasformare frasi in vettori di significato (embeddings). Per ogni categoria scriviamo tre frasi di esempio; ogni nuovo ticket viene assegnato alla categoria che contiene l’esempio più simile. È una forma di classificazione few-shot, e la usiamo con un modello di embedding multilingue:
<?php

declare(strict_types=1);

use Codewithkyrian\Transformers\Pipelines\Pipeline;

final class SmistatoreTicket
{
    /** @var array<string, list<list<float>>> */
    private array $esempi = [];

    /** @param array<string, list<string>> $esempiPerCategoria */
    public function __construct(private readonly Pipeline $embeddings, array $esempiPerCategoria)
    {
        foreach ($esempiPerCategoria as $categoria => $frasi) {
            $this->esempi[$categoria] = $this->vettori($frasi);
        }
    }

    /** @return array{categoria: string, punteggio: float} */
    public function classifica(string $testo): array
    {
        [$v] = $this->vettori([$testo]);

        $migliore = ['categoria' => '', 'punteggio' => -1.0];
        foreach ($this->esempi as $categoria => $vettori) {
            // punteggio della categoria = similarità con l'esempio più vicino
            $punteggio = max(array_map(fn (array $e): float => self::coseno($v, $e), $vettori));
            if ($punteggio > $migliore['punteggio']) {
                $migliore = ['categoria' => $categoria, 'punteggio' => $punteggio];
            }
        }

        return $migliore;
    }

    /** @param list<string> $frasi @return list<list<float>> */
    private function vettori(array $frasi): array
    {
        return ($this->embeddings)($frasi, pooling: 'mean');
    }

    /** @param list<float> $a @param list<float> $b */
    public static function coseno(array $a, array $b): float
    {
        $dot = $na = $nb = 0.0;
        foreach ($a as $i => $x) {
            $dot += $x * $b[$i];
            $na += $x * $x;
            $nb += $b[$i] * $b[$i];
        }

        return $dot / (sqrt($na) * sqrt($nb));
    }
}
Gli embeddings degli esempi vengono calcolati una sola volta, nel costruttore. Il parametro pooling: 'mean' combina i vettori delle singole parole in un unico vettore per frase. La similarità è calcolata come coseno completo, dividendo per le norme dei due vettori: nelle prove i vettori restituiti non risultavano normalizzati nemmeno chiedendolo esplicitamente, e un prodotto scalare semplice avrebbe dato valori privi di senso. È una buona regola generale: non presupporre, verificare.
$smistatore = new SmistatoreTicket(
    pipeline('embeddings', 'Xenova/paraphrase-multilingual-MiniLM-L12-v2'),
    [
        'accesso' => [
            'Non riesco a entrare nel mio account',
            'Ho dimenticato la password',
            'Il codice di verifica via SMS non arriva',
        ],
        'fatturazione' => [
            'Mi è stato addebitato un importo sbagliato',
            'Vorrei la fattura del mese scorso',
            'Il pagamento con carta è stato rifiutato',
        ],
        'commerciale' => [
            'Quali funzionalità include il piano Pro?',
            'Vorrei un preventivo per 20 utenti',
            'Avete sconti per le associazioni?',
        ],
    ],
);

$esito = $smistatore->classifica('Il link per reimpostare la password è scaduto');
Questi sono i risultati reali su sei ticket mai visti:
| Ticket | Categoria assegnata | Punteggio | Esito |
|---|---|---|---|
| Non riesco ad accedere al mio account, la password non viene accettata | accesso | 0,80 | corretto |
| Mi avete addebitato due volte l’abbonamento di marzo | fatturazione | 0,49 | corretto |
| Vorrei sapere se il piano Pro include la fatturazione elettronica | commerciale | 0,58 | corretto |
| Il link per reimpostare la password è scaduto | accesso | 0,71 | corretto |
| Posso pagare con bonifico invece che con carta? | fatturazione | 0,60 | corretto |
| Fate prezzi speciali per le scuole? | fatturazione | 0,21 | errato |
Cinque su sei, e i tre casi in cui lo zero-shot aveva sbagliato ora sono corretti. Ma il dato più interessante è l’errore: la domanda sulle scuole è stata assegnata alla fatturazione con un punteggio di appena 0,21, molto più basso degli altri. Il modello ci sta dicendo che non è sicuro. Basta introdurre una soglia minima (ad esempio 0,40) sotto la quale il ticket va in una coda di smistamento manuale: l’errore diventa un caso da verificare invece di un messaggio finito nel posto sbagliato. E la soluzione strutturale è semplice: aggiungere alla categoria commerciale un esempio sui prezzi per scuole o enti.
Questo approccio ha un altro vantaggio pratico: per migliorare il sistema non serve riaddestrare nulla, basta aggiungere frasi di esempio. Chi gestisce il servizio clienti può farlo senza toccare il codice.
Prestazioni
Le misure, su una macchina con due vCPU e il modello quantizzato di circa 130 MB, sono queste:
- caricamento del modello: circa 1,8 secondi con i file già in cache (diversi secondi in più al primo download);
- classificazione di un ticket: circa 5 millisecondi;
- memoria di picco del processo PHP: circa 270 MB.
Il rapporto tra i primi due numeri spiega l’architettura giusta. Se il modello venisse caricato a ogni richiesta web, ogni pagina pagherebbe quasi due secondi di attesa. Il modello va invece caricato una volta in un processo che resta attivo e serve molte richieste: un worker di coda (Symfony Messenger, Laravel Queue), un piccolo servizio interno o un runtime PHP persistente. In questo modo FFI resta confinato ai processi da riga di comando e la configurazione di PHP-FPM non deve essere toccata.
Cose da sapere prima di andare in produzione
- Licenze dei modelli. La libreria è open source, ma ogni modello ha la propria licenza, indicata nella sua scheda su Hugging Face. Va verificata prima dell’uso commerciale.
- Scelta del modello. Modelli più grandi sono più accurati ma più lenti e più pesanti. Conviene partire dal più piccolo che dà risultati accettabili sul proprio insieme di prova.
- Valutazione. Come nelle parti precedenti, servono esempi etichettati e una misura: la differenza tra zero-shot e few-shot, in questo caso, l’hanno mostrata i numeri, non le aspettative.
- Niente GPU. In questa configurazione l’inferenza avviene su CPU. Va benissimo per embeddings e classificazione, molto meno per modelli generativi di grandi dimensioni.
- Maturità. La libreria è giovane (la versione è ancora 0.x) e alcuni comportamenti possono cambiare tra una versione e l’altra: conviene fissare la versione in
composer.jsone coprire con test i punti critici.
Conclusione
TransformersPHP rende possibile qualcosa che fino a poco tempo fa sembrava fuori portata: eseguire reti neurali moderne dentro un’applicazione PHP, senza servizi esterni e senza inviare dati a terzi. Ma la lezione più utile di questo esperimento è un’altra: la tecnica più “magica” (lo zero-shot) si è rivelata la meno affidabile, mentre una soluzione semplice (embeddings, pochi esempi, una soglia) ha funzionato bene ed è facile da mantenere.
Nella prossima parte allargheremo lo sguardo all’intero ecosistema: come si è passati dagli array di PHP ai tensori e alla GPU, quali estensioni e librerie esistono oggi e quale ruolo ha davvero PHP in un’applicazione che usa l’intelligenza artificiale.
Serie “PHP e intelligenza artificiale” – parte 4 di 8.
← Parte precedente: Machine learning in PHP, senza Python
Parte successiva: Dagli array alla GPU: l’ecosistema ML di PHP →