Contratti, email, ticket di assistenza, verbali: buona parte dei dati che un’applicazione gestisce arriva sotto forma di testo libero. Dentro quel testo ci sono informazioni strutturate che varrebbe la pena estrarre: chi sono le persone coinvolte, quali aziende, quali luoghi, quali date e quali importi. Il compito di individuarle si chiama Named Entity Recognition, in breve NER.
Con questo articolo apriamo una serie dedicata all’intelligenza artificiale vista da chi sviluppa in PHP: non teoria fine a sé stessa, ma problemi concreti da risolvere dentro applicazioni reali. Partiamo dalla NER perché è un caso esemplare: PHP da solo non basta, ma nemmeno serve riscrivere l’applicazione in un altro linguaggio. Vedremo le strade possibili, ne sceglieremo una e la costruiremo per intero, misurandone qualità e prestazioni.
Che cos’è la NER
Un sistema di NER riceve un testo e restituisce un elenco di entità: porzioni di testo con una categoria e una posizione. Nella frase “Giulia Bianchi ha firmato a Milano un contratto con Acme Servizi S.p.A.” ci aspettiamo tre entità: una persona, un luogo e un’organizzazione.
Le categorie dipendono dal modello. Quelli addestrati su testi giornalistici usano di solito etichette come PER (persone), LOC (luoghi), ORG (organizzazioni) e MISC (tutto il resto). Altri distinguono anche date, quantità, prodotti, eventi. È il primo dettaglio da verificare: il modello italiano piccolo di spaCy, quello che useremo, riconosce solo PER, LOC, ORG e MISC. Date e importi non li vede.
Esistono due grandi famiglie di approcci. I sistemi a regole usano espressioni regolari e dizionari: sono veloci, prevedibili e perfetti per entità con un formato rigido (un codice fiscale, un indirizzo email, una data). I modelli statistici, oggi basati su reti neurali, imparano dagli esempi a riconoscere entità che non hanno un formato: nessuna espressione regolare può sapere che “Bianchi” è un cognome e “Milano” una città. Come vedremo, la soluzione migliore spesso le combina.
Le strade possibili in un progetto PHP
L’ecosistema PHP non ha una tradizione di elaborazione del linguaggio naturale paragonabile a quella di Python. Le opzioni concrete sono quattro:
| Approccio | Vantaggi | Svantaggi |
|---|---|---|
| API esterna (servizi cloud, LLM) | Nessuna infrastruttura, qualità spesso alta, molte lingue | Costo a chiamata, latenza di rete, dati inviati a terzi, dipendenza dal fornitore |
| Regole in PHP puro | Velocissime, deterministiche, nessuna dipendenza | Inadatte a nomi propri e testi liberi |
| Modelli ONNX eseguiti da PHP via FFI | Tutto nello stesso processo, nessun servizio esterno | Richiede l’estensione FFI, memoria elevata nei worker, ecosistema ancora giovane |
| Microservizio Python affiancato | Accesso all’ecosistema NLP più maturo, isolamento, scalabilità separata | Un servizio in più da distribuire e monitorare |
Il criterio dei dati merita attenzione particolare. Testi come contratti, email e pratiche contengono quasi sempre dati personali: inviarli a un servizio esterno significa coinvolgere un altro soggetto nel trattamento, con tutto ciò che ne consegue in termini di nomine, informative e trasferimenti verso Paesi terzi. Tenere l’analisi all’interno della propria infrastruttura semplifica molto il quadro.
L’esecuzione di modelli direttamente dentro PHP è una strada interessante a cui dedicheremo un articolo della serie. Per un primo progetto in produzione, però, il microservizio affiancato è la scelta più solida: PHP resta il centro dell’applicazione, Python fa soltanto ciò che sa fare meglio.
L’architettura: un approccio ibrido
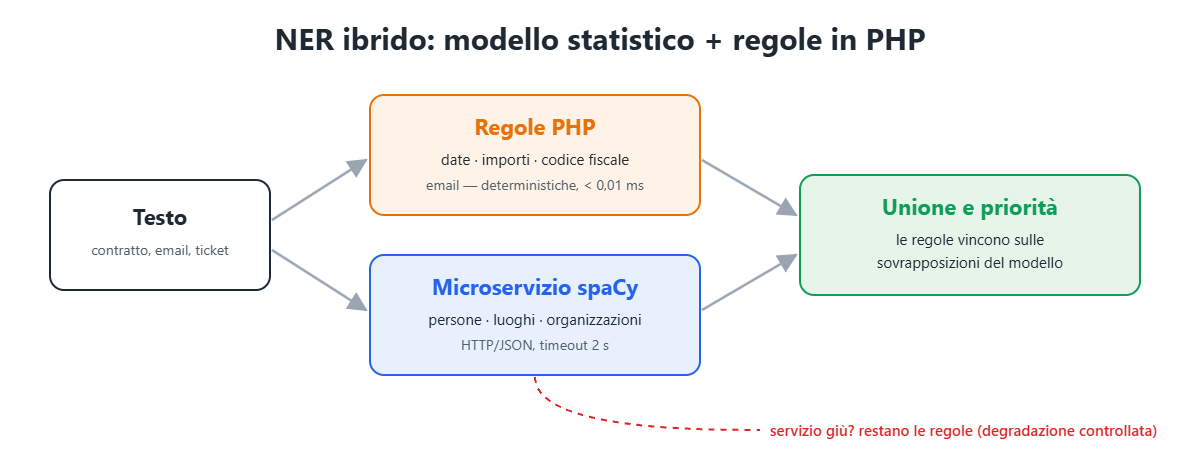
L’idea è semplice. Le entità con un formato rigido (date, importi, codici fiscali, email) le estraiamo in PHP con regole deterministiche. Le entità “linguistiche” (persone, luoghi, organizzazioni) le chiediamo a un microservizio basato su spaCy. Poi uniamo i risultati, dando priorità alle regole quando le due fonti si sovrappongono. E se il microservizio non risponde, l’applicazione continua a funzionare con le sole regole invece di andare in errore.
Il microservizio Python
spaCy è una libreria NLP matura, con modelli pronti per l’italiano. La esponiamo con FastAPI, un framework che valida automaticamente l’input e genera la documentazione dell’API. Il servizio completo sta in poche righe:
# ner-service/app.py
from functools import lru_cache

import spacy
from fastapi import FastAPI
from pydantic import BaseModel, Field

app = FastAPI(title="ner-service")


class AnalisiRichiesta(BaseModel):
    testo: str = Field(min_length=1, max_length=20_000)
    lingua: str = "it"


MODELLI = {"it": "it_core_news_sm"}


@lru_cache(maxsize=None)
def modello(lingua: str):
    # il modello viene caricato una sola volta per processo
    return spacy.load(MODELLI[lingua])


@app.get("/health")
def health():
    return {"stato": "ok"}


@app.post("/entita")
def entita(richiesta: AnalisiRichiesta):
    doc = modello(richiesta.lingua)(richiesta.testo)
    return {
        "entita": [
            {"testo": e.text, "tipo": e.label_, "inizio": e.start_char, "fine": e.end_char}
            for e in doc.ents
        ]
    }
Tre dettagli contano. Il modello viene caricato una sola volta per processo: caricarlo a ogni richiesta costerebbe secondi. La lunghezza del testo è limitata, per evitare che una richiesta enorme blocchi un worker. Le posizioni restituite sono in caratteri, non in byte: ci servirà ricordarlo in PHP.
Il Dockerfile installa le dipendenze e scarica il modello in fase di build, così il container parte già pronto:
# ner-service/Dockerfile
FROM python:3.12-slim

WORKDIR /app
RUN pip install --no-cache-dir spacy fastapi "uvicorn[standard]" \
    && python -m spacy download it_core_news_sm

COPY app.py .
EXPOSE 8000
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000", "--workers", "2"]
Con Docker Compose il servizio vive accanto all’applicazione PHP, raggiungibile solo dalla rete interna:
# compose.yaml
services:
  app:
    image: php:8.4-fpm
    environment:
      NER_URL: http://ner:8000
    depends_on:
      ner:
        condition: service_healthy

  ner:
    build: ./ner-service
    healthcheck:
      test: ["CMD", "python", "-c", "import urllib.request; urllib.request.urlopen('http://localhost:8000/health')"]
      interval: 10s
      timeout: 3s
      retries: 5
Il lato PHP
Un oggetto per le entità
Per prima cosa definiamo un tipo per le entità, indipendente dalla fonte che le ha prodotte:
final readonly class Entita
{
    public function __construct(
        public string $testo,
        public string $tipo,
        public int $inizio,
        public int $fine,
        public string $fonte, // "modello" oppure "regola"
    ) {
    }
}
Il client HTTP
Il client usa cURL, disponibile ovunque, con timeout espliciti: mezzo secondo per la connessione e due secondi in totale. Un servizio di supporto lento non deve trascinare con sé l’intera richiesta dell’utente.
final class ServizioNerNonDisponibile extends RuntimeException
{
}

final readonly class ClientNer
{
    public function __construct(
        private string $baseUrl = 'http://ner:8000',
        private float $timeoutSecondi = 2.0,
    ) {
    }

    /** @return list<Entita> */
    public function analizza(string $testo, string $lingua = 'it'): array
    {
        $ch = curl_init(rtrim($this->baseUrl, '/') . '/entita');
        curl_setopt_array($ch, [
            CURLOPT_POST => true,
            CURLOPT_HTTPHEADER => ['Content-Type: application/json', 'Accept: application/json'],
            CURLOPT_POSTFIELDS => json_encode(['testo' => $testo, 'lingua' => $lingua], JSON_THROW_ON_ERROR),
            CURLOPT_RETURNTRANSFER => true,
            CURLOPT_CONNECTTIMEOUT_MS => 500,
            CURLOPT_TIMEOUT_MS => (int) ($this->timeoutSecondi * 1000),
        ]);

        $corpo = curl_exec($ch);
        $stato = curl_getinfo($ch, CURLINFO_RESPONSE_CODE);
        $errore = curl_error($ch);
        curl_close($ch);

        if ($corpo === false || $stato !== 200) {
            throw new ServizioNerNonDisponibile("Servizio NER non disponibile (HTTP $stato) $errore");
        }

        $dati = json_decode($corpo, true, flags: JSON_THROW_ON_ERROR);

        return array_map(
            static fn (array $e): Entita => new Entita($e['testo'], $e['tipo'], $e['inizio'], $e['fine'], 'modello'),
            $dati['entita'],
        );
    }
}
In un progetto Symfony o Laravel si userà naturalmente il client HTTP del framework; la logica non cambia.
Le regole
Le regole coprono ciò che il modello non vede. Il dettaglio più insidioso è la posizione: preg_match_all con PREG_OFFSET_CAPTURE restituisce offset in byte, mentre spaCy li restituisce in caratteri. Con testi italiani pieni di lettere accentate, che in UTF-8 occupano due byte, le due misure divergono subito. Per questo convertiamo l’offset con mb_strlen():
final class RegoleEntita
{
    private const MESI = 'gennaio|febbraio|marzo|aprile|maggio|giugno|luglio|agosto|settembre|ottobre|novembre|dicembre';

    /** @return list<Entita> */
    public function estrai(string $testo): array
    {
        $regole = [
            'DATA' => '/\b(?:\d{1,2}\/\d{1,2}\/\d{4}|\d{1,2}\s+(?:' . self::MESI . ')(?:\s+\d{4})?)\b/iu',
            'IMPORTO' => '/(?:€\s?\d{1,3}(?:\.\d{3})*(?:,\d{2})?|\b\d{1,3}(?:\.\d{3})*(?:,\d{2})?\s?(?:euro|EUR)\b)/u',
            'CODICE_FISCALE' => '/\b[A-Z]{6}\d{2}[A-EHLMPRST]\d{2}[A-Z]\d{3}[A-Z]\b/u',
            'EMAIL' => '/\b[\w.+-]+@[\w-]+(?:\.[\w-]+)+\b/u',
        ];

        $trovate = [];
        foreach ($regole as $tipo => $pattern) {
            preg_match_all($pattern, $testo, $match, PREG_OFFSET_CAPTURE);
            foreach ($match[0] as [$valore, $offsetByte]) {
                // preg restituisce offset in byte: li convertiamo in caratteri come fa spaCy
                $inizio = mb_strlen(substr($testo, 0, $offsetByte));
                $trovate[] = new Entita($valore, $tipo, $inizio, $inizio + mb_strlen($valore), 'regola');
            }
        }

        return $trovate;
    }
}
L’espressione per il codice fiscale verifica solo la forma, non il carattere di controllo finale: per una validazione completa va aggiunto il calcolo del check digit. Le regole qui sono volutamente essenziali; in un progetto reale andranno estese ai formati che compaiono davvero nei documenti (numeri di pratica, targhe, protocolli).
L’unione dei risultati
L’estrattore combina le due fonti. Se il microservizio non risponde, l’eccezione viene intercettata e si prosegue con le sole regole: è la degradazione controllata. Le entità del modello che si sovrappongono a quelle trovate dalle regole vengono scartate, perché su quei formati le regole sono più affidabili.
final readonly class EstrattoreEntita
{
    public function __construct(
        private ClientNer $client,
        private RegoleEntita $regole,
    ) {
    }

    /** @return list<Entita> */
    public function estrai(string $testo): array
    {
        $daRegole = $this->regole->estrai($testo);

        try {
            $daModello = $this->client->analizza($testo);
        } catch (ServizioNerNonDisponibile) {
            // degradazione controllata: senza modello restano le regole deterministiche
            $daModello = [];
        }

        // le regole hanno precedenza: scartiamo le entità del modello che si sovrappongono
        $daModello = array_filter(
            $daModello,
            static function (Entita $m) use ($daRegole): bool {
                foreach ($daRegole as $r) {
                    if ($m->inizio < $r->fine && $r->inizio < $m->fine) {
                        return false;
                    }
                }
                return true;
            },
        );

        $tutte = [...$daRegole, ...$daModello];
        usort($tutte, static fn (Entita $a, Entita $b): int => $a->inizio <=> $b->inizio);

        return $tutte;
    }
}
Proviamolo
$testo = 'Il 3 marzo 2026 Giulia Bianchi (BNCGLI85C41H501Z) ha firmato a Milano un contratto '
    . 'con Acme Servizi S.p.A. per € 12.500,00. Referente: giulia.bianchi@example.com';

$estrattore = new EstrattoreEntita(new ClientNer(getenv('NER_URL')), new RegoleEntita());

foreach ($estrattore->estrai($testo) as $e) {
    printf("%-15s %-28s [%d-%d] %s\n", $e->tipo, $e->testo, $e->inizio, $e->fine, $e->fonte);
}
Questo è l’output reale ottenuto con il modello it_core_news_sm (il codice fiscale dell’esempio è fittizio):
DATA            3 marzo 2026                 [3-15] regola
PER             Giulia Bianchi               [16-30] modello
CODICE_FISCALE  BNCGLI85C41H501Z             [32-48] regola
LOC             Milano                       [63-69] modello
PER             Acme Servizi                 [87-99] modello
IMPORTO         € 12.500,00                  [111-122] regola
EMAIL           giulia.bianchi@example.com   [135-161] regola
Il risultato è utile ma non perfetto, e l’errore è istruttivo: “Acme Servizi” viene classificata come persona invece che come organizzazione, e la forma societaria “S.p.A.” resta fuori. È il comportamento tipico di un modello piccolo davanti a nomi che non ha mai visto. Spegnendo il microservizio, l’output si riduce alle quattro entità trovate dalle regole, senza alcun errore applicativo.
Misurare la qualità
“Sembra funzionare” non è una metrica. Prima di affidarsi a un sistema di NER conviene costruire un piccolo insieme di testi annotati a mano, rappresentativi dei documenti reali, e misurare due grandezze: la precisione (quante entità trovate sono giuste) e il richiamo (quante entità giuste sono state trovate). La loro media armonica è l’F1.
/**
 * @param list<Entita> $previste
 * @param list<array{0:string,1:int,2:int}> $attese  [tipo, inizio, fine]
 * @return array{precisione: float, richiamo: float, f1: float}
 */
function valuta(array $previste, array $attese): array
{
    $chiave = static fn (string $tipo, int $inizio, int $fine): string => "$tipo:$inizio:$fine";

    $p = array_map(static fn (Entita $e) => $chiave($e->tipo, $e->inizio, $e->fine), $previste);
    $a = array_map(static fn (array $e) => $chiave(...$e), $attese);

    $corrette = count(array_intersect($p, $a));
    $precisione = $p === [] ? 0.0 : $corrette / count($p);
    $richiamo = $a === [] ? 0.0 : $corrette / count($a);
    $f1 = ($precisione + $richiamo) > 0 ? 2 * $precisione * $richiamo / ($precisione + $richiamo) : 0.0;

    return ['precisione' => $precisione, 'richiamo' => $richiamo, 'f1' => $f1];
}
Sulla frase dell’esempio, con quattro entità attese, il sistema ottiene 0,75 su tutte e tre le metriche: tre entità corrette su quattro trovate, tre trovate su quattro attese. Il confronto qui è “esatto” (stesso tipo, stesse posizioni); in alcuni contesti ha senso accettare anche sovrapposizioni parziali. Con un centinaio di frasi annotate si ottiene già un’indicazione affidabile, e soprattutto un riferimento per capire se un cambiamento migliora o peggiora le cose.
Se la qualità non basta, le leve sono tre: passare a un modello più grande (spaCy offre per l’italiano anche le versioni md e lg, più accurate ma più pesanti), aggiungere regole o dizionari per i nomi ricorrenti (le ragioni sociali dei propri clienti, ad esempio), oppure addestrare il modello sui propri documenti.
Prestazioni e messa in produzione
Su una macchina con due vCPU, con il modello piccolo e una frase di una ventina di parole, la chiamata dal client PHP al microservizio ha richiesto in media circa 6 millisecondi su 200 richieste; le regole in PHP meno di un centesimo di millisecondo. Sono numeri indicativi, che crescono con la lunghezza dei testi e con modelli più grandi, ma rendono l’idea: per l’uso interattivo il costo è trascurabile. Alcune raccomandazioni:
- Timeout sempre espliciti e degradazione controllata, come visto sopra.
- Elaborazioni massive in coda. Per analizzare migliaia di documenti conviene un worker asincrono (ad esempio Symfony Messenger) e, lato Python, l’elaborazione a lotti con
nlp.pipe(), molto più efficiente delle chiamate singole. - Numero di worker. Ogni worker di uvicorn carica il proprio modello in memoria: si dimensiona in base alla RAM disponibile.
- Rete interna. Il servizio non deve essere esposto su Internet: riceve testi potenzialmente riservati.
- Versionare il modello. Cambiare modello cambia i risultati: va trattato come un rilascio, rieseguendo la valutazione.
Conclusione
Per riconoscere le entità nei testi un’applicazione PHP non deve diventare un’applicazione Python: basta affiancarle un piccolo servizio specializzato e integrarlo con cura. Timeout, degradazione controllata, regole deterministiche dove servono e una misura oggettiva della qualità fanno la differenza tra una demo e una funzionalità affidabile.
Nella prossima parte faremo un passo ulteriore: useremo un framework PHP per costruire un sistema di Retrieval-Augmented Generation, che risponde a domande in linguaggio naturale partendo dai documenti della nostra applicazione.
Serie “PHP e intelligenza artificiale” – parte 1 di 8.
Parte successiva: Un assistente che risponde con i tuoi documenti (RAG) →