Nelle parti precedenti abbiamo usato l’intelligenza artificiale in PHP in modi molto diversi: addestrando un modello in PHP puro, eseguendo reti neurali tramite una libreria nativa, orchestrando modelli esterni. Viene spontaneo chiedersi quale sia la strada “giusta”, e soprattutto dove stia il limite di PHP.
Per rispondere serve capire una cosa sola: tutto il machine learning, alla fine, è calcolo su grandi quantità di numeri. Vettori, matrici, tensori. In questa parte misuriamo quanto costa questo calcolo in PHP, perché costa così tanto, e come l’ecosistema si è organizzato per aggirare il problema. Con un benchmark che chiunque può rifare.
Tutto è moltiplicazione di matrici
Un livello di una rete neurale riceve un vettore di numeri, lo moltiplica per una matrice di pesi, aggiunge un vettore e applica una funzione. Un modello di embedding come quello usato nella parte precedente ripete questa operazione decine di volte per ogni frase. Addestrare un modello significa ripeterla milioni di volte. Per questo la velocità con cui un ambiente esegue il prodotto tra matrici è un buon indicatore della sua idoneità al machine learning.
L’esperimento
Moltiplichiamo due matrici quadrate di numeri casuali in quattro modi:
- con gli array di PHP e tre cicli annidati;
- con gli stessi array, attivando il compilatore JIT di PHP;
- delegando il calcolo alla funzione
cblas_dgemmdella libreria BLAS di riferimento, richiamata tramite FFI; - delegandolo a OpenBLAS, un’implementazione di BLAS ottimizzata per i processori moderni, anch’essa via FFI.
BLAS (Basic Linear Algebra Subprograms) è l’interfaccia standard, nata negli anni Settanta, per le operazioni di algebra lineare. Quasi tutte le librerie scientifiche, NumPy compresa, finiscono per chiamarla. La versione PHP pura usa l’ordine dei cicli più favorevole alla cache del processore:
function moltiplicaPhp(array $a, array $b, int $n): array
{
    $c = array_fill(0, $n, array_fill(0, $n, 0.0));
    for ($i = 0; $i < $n; $i++) {
        $ai = $a[$i];
        $ci = $c[$i];
        for ($k = 0; $k < $n; $k++) {
            $aik = $ai[$k];
            $bk = $b[$k];
            for ($j = 0; $j < $n; $j++) {
                $ci[$j] += $aik * $bk[$j];
            }
        }
        $c[$i] = $ci;
    }

    return $c;
}
La versione nativa dichiara a FFI la firma della funzione C, copia i dati in buffer nativi, chiama BLAS e ricopia il risultato in un array PHP:
function moltiplicaBlas(array $a, array $b, int $n, string $libreria): array
{
    $ffi = FFI::cdef(
        'void cblas_dgemm(int Order, int TransA, int TransB, int M, int N, int K,
                          double alpha, const double *A, int lda, const double *B, int ldb,
                          double beta, double *C, int ldc);',
        $libreria,
    );

    // copia dagli array PHP alla memoria nativa (row-major)
    $A = FFI::new("double[$n*$n]");
    $B = FFI::new("double[$n*$n]");
    $C = FFI::new("double[$n*$n]");
    for ($i = 0, $p = 0; $i < $n; $i++) {
        for ($j = 0; $j < $n; $j++, $p++) {
            $A[$p] = $a[$i][$j];
            $B[$p] = $b[$i][$j];
        }
    }

    // 101 = CblasRowMajor, 111 = CblasNoTrans
    $ffi->cblas_dgemm(101, 111, 111, $n, $n, $n, 1.0, $A, $n, $B, $n, 0.0, $C, $n);

    // copia del risultato in un array PHP
    $c = [];
    for ($i = 0, $p = 0; $i < $n; $i++) {
        for ($j = 0; $j < $n; $j++, $p++) {
            $c[$i][$j] = $C[$p];
        }
    }

    return $c;
}
In poche righe abbiamo fatto esattamente ciò che fanno, in modo più curato, le librerie dell’ecosistema: usare PHP per preparare i dati e una libreria nativa per calcolare. Il percorso della libreria (ad esempio /usr/lib/x86_64-linux-gnu/openblas-pthread/libblas.so.3 su Ubuntu) dipende dal sistema.
I risultati
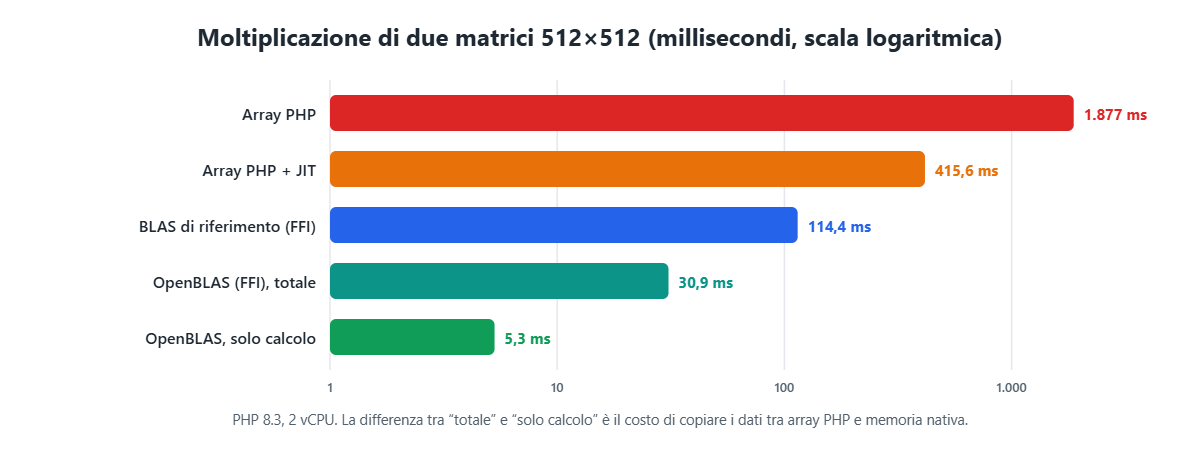
Questi sono i tempi misurati con PHP 8.3 su una macchina con due vCPU, per diverse dimensioni delle matrici (tutte le versioni producono lo stesso risultato numerico):
| Dimensione | Array PHP | Array PHP + JIT | BLAS di riferimento | OpenBLAS (totale) | OpenBLAS (solo calcolo) |
|---|---|---|---|---|---|
| 128 × 128 | 30 ms | 7 ms | 4 ms | 5 ms | 0,2 ms |
| 256 × 256 | 230 ms | 78 ms | 17 ms | 9 ms | 1,1 ms |
| 512 × 512 | 1.877 ms | 416 ms | 114 ms | 31 ms | 5,3 ms |
| 1024 × 1024 | — | — | 720 ms | 129 ms | 33 ms |
Tre osservazioni.
Primo: gli array di PHP sono lenti per questo lavoro, e il motivo è strutturale. A 512×512, OpenBLAS calcola il prodotto circa 350 volte più in fretta del codice PHP. Non è colpa di chi ha scritto il ciclo: ogni operazione passa dall’interprete, ogni numero è un valore generico che porta con sé il proprio tipo, e la memoria non è disposta in modo contiguo. Una misura lo rende evidente: una matrice 512×512 in un array PHP occupa circa 6 MB, circa 24 byte per numero, contro i 2 MB (8 byte per numero) di un buffer nativo di double.
Secondo: il JIT aiuta parecchio, ma non cambia categoria. Attivando il compilatore JIT (opcache.jit=tracing) il codice PHP diventa da tre a cinque volte più veloce. È un miglioramento notevole, che rende il PHP puro adatto a calcoli di dimensione moderata, ma resta lontano dalle librerie ottimizzate, che sfruttano istruzioni vettoriali del processore, più core e un uso accurato della cache.
Terzo, il più importante: spostare i dati costa più che calcolare. Con OpenBLAS a 512×512, il calcolo vero e proprio richiede 5,3 millisecondi, mentre l’operazione completa ne richiede 31. Quasi tutto il tempo se ne va a copiare i numeri dagli array PHP alla memoria nativa e ritorno. È la stessa lezione che vale, moltiplicata, per la GPU: la scheda grafica calcola rapidissimamente, ma i dati vanno prima trasferiti nella sua memoria. Il segreto delle prestazioni non è soltanto una libreria veloce: è tenere i dati nel formato nativo il più a lungo possibile, invece di convertirli avanti e indietro a ogni operazione.
Come si è organizzato l’ecosistema
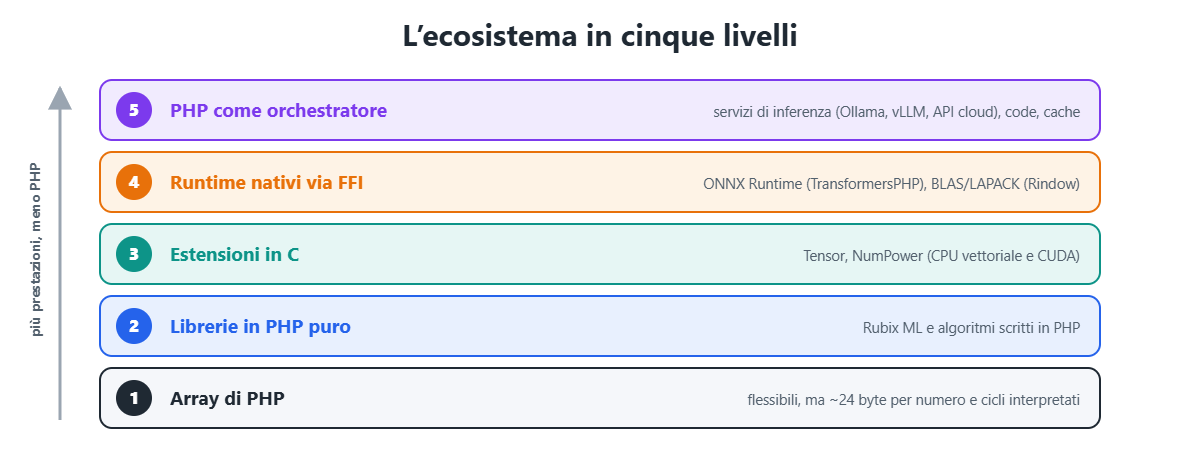
Le librerie per il machine learning in PHP si possono leggere come risposte diverse ai tre problemi emersi dal benchmark: l’interprete, la memoria e lo spostamento dei dati.
1. Array di PHP
Flessibili, onnipresenti, adatti a prototipi, a dataset piccoli e agli algoritmi didattici. Ne vedremo il valore nella prossima parte, dove implementeremo da zero un algoritmo classico di elaborazione del testo.
2. Librerie in PHP puro
Rubix ML, usata nella terza parte della serie, implementa decine di algoritmi completamente in PHP. Il vantaggio è la portabilità assoluta: funziona ovunque giri PHP, senza estensioni né librerie di sistema. Per i dati tabellari di dimensione media e per gli algoritmi classici (alberi, foreste, k-NN, regressioni) le prestazioni sono più che sufficienti.
3. Estensioni in C
Il passo successivo è portare le strutture dati fuori dagli array di PHP. Tensor, dello stesso ecosistema di Rubix ML, offre vettori e matrici con un’implementazione in PHP e un’estensione opzionale in C che ne accelera le operazioni. NumPower si ispira dichiaratamente a NumPy: un’estensione che gestisce array multidimensionali nativi, usa le istruzioni vettoriali dei processori moderni e, se compilata con il supporto CUDA, può eseguire le operazioni su una GPU NVIDIA. Nato come progetto indipendente, è proseguito come fork all’interno dell’organizzazione Rubix ML. Il suo modello di utilizzo rende esplicito il punto del benchmark: i dati vanno copiati nella memoria della GPU prima del calcolo, ed è lì che conviene tenerli.
Il prezzo delle estensioni è l’installazione: vanno compilate e abilitate sul server, cosa non sempre possibile su hosting condivisi o in ambienti gestiti.
4. Runtime nativi via FFI
FFI permette di usare librerie native già esistenti senza scrivere un’estensione. È la strada di TransformersPHP, che delega l’esecuzione dei modelli a ONNX Runtime, e di Rindow Math Matrix, una libreria di algebra lineare che può appoggiarsi a OpenBLAS. Esiste anche un binding diretto di ONNX Runtime per PHP. Il vantaggio è sfruttare decenni di ottimizzazioni scritte da altri; il prezzo, come abbiamo visto, è la necessità di FFI abilitato e una certa attenzione al confine tra i due mondi.
5. PHP come orchestratore
L’ultimo livello capovolge la prospettiva: PHP non calcola affatto. I modelli girano in servizi specializzati (un server di inferenza locale come Ollama o vLLM, un microservizio Python, un’API cloud) e PHP fa ciò che sa fare meglio: ricevere richieste, gestire utenti e permessi, preparare il contesto, mettere in coda i lavori lunghi, salvare i risultati, presentare l’interfaccia. È il ruolo di framework come Neuron AI, ed è quello che vedremo in dettaglio nella parte dedicata agli agenti.
Quale livello scegliere
| Esigenza | Livello consigliato |
|---|---|
| Capire un algoritmo, prototipare, dataset piccoli | Array e PHP puro |
| Modelli classici su dati tabellari dentro l’applicazione | Rubix ML |
| Calcolo numerico intensivo sul proprio server | Estensioni (Tensor, NumPower) o BLAS via FFI |
| Reti neurali pre-addestrate senza servizi esterni | ONNX Runtime via FFI (TransformersPHP) |
| Modelli linguistici di grandi dimensioni, GPU condivise, carichi variabili | Servizi di inferenza dedicati, con PHP come orchestratore |
Nella pratica i livelli si combinano: la stessa applicazione può calcolare una similarità in PHP puro, classificare un testo con un modello ONNX e affidare la generazione delle risposte a un servizio esterno. La domanda giusta non è “PHP può fare machine learning?”, ma “quale parte del lavoro conviene fare in PHP, e quale delegare?”.
Conclusione
Il benchmark racconta in numeri la storia dell’ecosistema. Gli array di PHP non sono fatti per il calcolo numerico intensivo, e nessuna ottimizzazione del codice cambia questo fatto. Il JIT riduce la distanza, le librerie native la annullano, e lo spostamento dei dati diventa il vero collo di bottiglia. Il ruolo di PHP si è spostato di conseguenza: sempre meno motore di calcolo, sempre più direttore d’orchestra.
Nella prossima parte torneremo però al PHP puro, per costruire da zero uno degli algoritmi più utili e sottovalutati dell’elaborazione del testo: Bag of Words e TF-IDF, con cui un computer trasforma le parole in numeri.
Serie “PHP e intelligenza artificiale” – parte 5 di 8.
← Parte precedente: Modelli neurali dentro PHP con TransformersPHP
Parte successiva: Bag of Words e TF-IDF →