Un computer non legge: confronta numeri. Ogni sistema che lavora con il testo (un motore di ricerca, un filtro antispam, un assistente come quello costruito nella seconda parte) deve prima risolvere lo stesso problema: trasformare le parole in numeri in modo che testi simili producano numeri simili.
Nella quarta parte l’abbiamo fatto con una rete neurale, ottenendo gli embeddings. Prima delle reti neurali, e ancora oggi in moltissimi sistemi, la risposta si chiamava Bag of Words e TF-IDF. Dopo aver visto nella parte precedente i limiti degli array di PHP nel calcolo numerico intensivo, qui mostriamo il caso opposto: un algoritmo che in PHP puro funziona benissimo. Lo costruiamo da zero, senza librerie, e lo usiamo per un motore di ricerca sulle FAQ di un servizio clienti.
Bag of Words: contare le parole
L’idea è disarmante. Si costruisce un vocabolario con tutte le parole che compaiono nei documenti e si rappresenta ogni documento con un vettore che conta quante volte vi compare ciascuna parola. L’ordine si perde: il documento diventa un “sacchetto” di parole, da cui il nome.
Prendiamo tre frasi: “Marco paga la fattura”, “Anna paga l’abbonamento”, “Marco scarica la fattura”. Escludendo gli articoli, il vocabolario contiene sei parole e ogni frase diventa una riga di sei numeri:
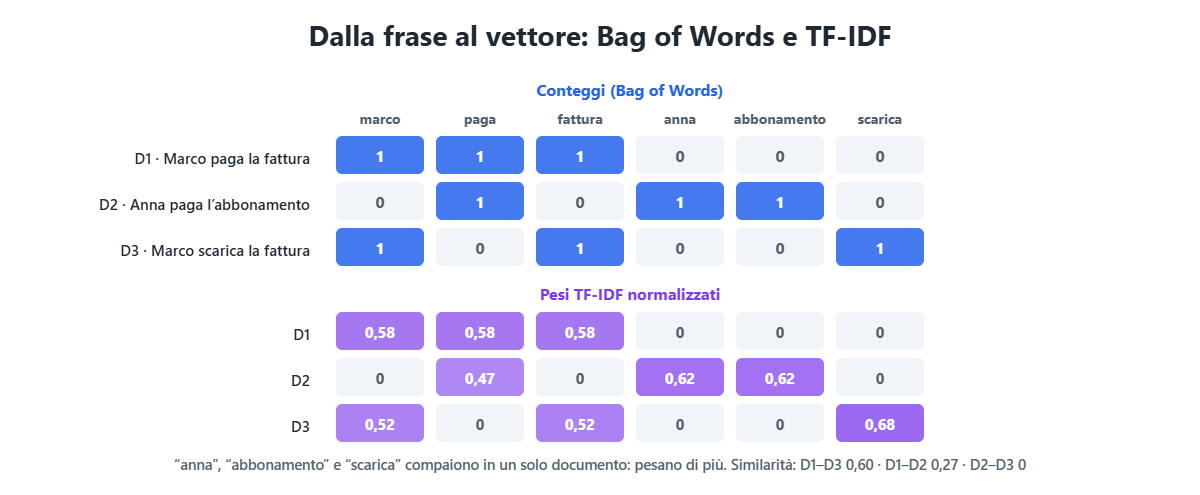
Già con i soli conteggi si può misurare la somiglianza: D1 e D3 condividono due parole (“marco” e “fattura”), D1 e D2 una sola, D2 e D3 nessuna. Ma i conteggi hanno un difetto: trattano tutte le parole allo stesso modo. In un archivio di FAQ di un servizio clienti, parole come “account” o “richiedere” compaiono ovunque e dicono poco; parole come “SMTP” o “spam” compaiono raramente e identificano l’argomento con precisione.
TF-IDF: pesare ciò che distingue
TF-IDF corregge il difetto combinando due misure:
- TF (term frequency): quante volte un termine compare nel documento. Più compare, più è rilevante per quel documento.
- IDF (inverse document frequency): quanto il termine è raro nell’intero archivio. Si calcola a partire dal rapporto tra il numero totale di documenti e quelli che contengono il termine, con un logaritmo che ne smorza la crescita.
Il peso di un termine in un documento è il prodotto delle due. Esistono diverse varianti della formula; useremo una versione “smussata” dell’IDF, molto diffusa, che evita divisioni per zero e valori negativi:
idf(t) = ln( (1 + N) / (1 + df(t)) ) + 1

dove N è il numero di documenti e df(t) il numero di documenti che contengono t
Nell’esempio, “marco”, “paga” e “fattura” compaiono in due documenti su tre e ricevono un IDF di 1,29; “anna”, “abbonamento” e “scarica” compaiono in uno solo e ricevono 1,69. Dopo la moltiplicazione, ogni vettore viene normalizzato, cioè diviso per la propria lunghezza, così che documenti lunghi e brevi siano confrontabili. La similarità tra due documenti è il coseno dell’angolo tra i loro vettori: 1 se sono identici, 0 se non condividono alcun termine. Con TF-IDF, D1 e D3 hanno similarità 0,60, D1 e D2 0,27, D2 e D3 zero.
L’implementazione in PHP
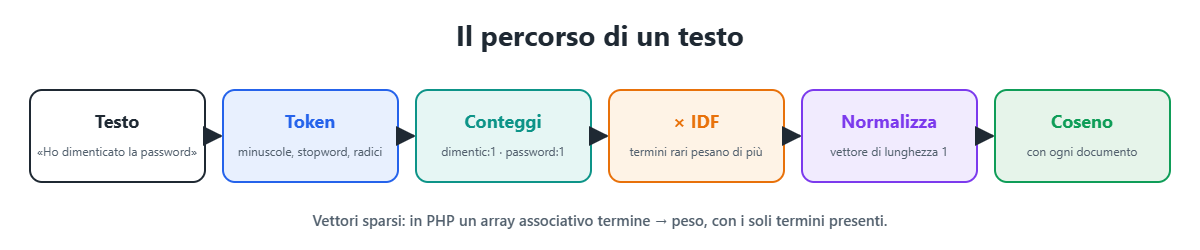
La tokenizzazione
La qualità di tutto il sistema dipende da come si spezza il testo in termini. Per l’italiano servono almeno tre accorgimenti: portare tutto in minuscolo, separare correttamente gli apostrofi (“l’account” deve produrre “account”) e ignorare le stopword, le parole grammaticali che compaiono ovunque. A questi aggiungiamo una riduzione molto semplice delle desinenze, perché “dimenticato” e “dimenticata” vengano riconosciute come lo stesso termine:
final class Tokenizzatore
{
    private const STOPWORD = [
        'a', 'ad', 'al', 'alla', 'alle', 'allo', 'agli', 'ai', 'anche', 'che', 'chi', 'ci', 'come', 'con',
        'da', 'dal', 'dalla', 'dei', 'del', 'della', 'delle', 'dello', 'degli', 'di', 'e', 'è', 'ed', 'gli',
        'ha', 'hanno', 'ho', 'i', 'il', 'in', 'io', 'la', 'le', 'lo', 'ma', 'mi', 'mio', 'mia', 'ne', 'nel',
        'nella', 'non', 'o', 'per', 'più', 'può', 'quando', 'se', 'si', 'sono', 'su', 'sul', 'sulla', 'ti',
        'tra', 'un', 'una', 'uno', 'vi', 'cosa', 'dove', 'questo', 'questa', 'mie', 'miei',
    ];

    /** @return list<string> */
    public function tokenizza(string $testo): array
    {
        $testo = mb_strtolower($testo);
        // separa anche gli apostrofi: "l'accesso" → "l", "accesso"
        $parole = preg_split('/[^\p{L}\p{N}]+/u', $testo, -1, PREG_SPLIT_NO_EMPTY);

        $stop = array_flip(self::STOPWORD);
        $token = [];
        foreach ($parole as $parola) {
            if (isset($stop[$parola]) || mb_strlen($parola) < 2) {
                continue;
            }
            $token[] = $this->radice($parola);
        }

        return $token;
    }

    /** Riduzione molto semplice delle desinenze più comuni (non è un vero stemmer). */
    private function radice(string $parola): string
    {
        if (mb_strlen($parola) <= 4) {
            return $parola;
        }

        return preg_replace('/(azioni|azione|mente|ando|endo|ato|ata|ati|ate|ito|ita|iti|ite|are|ere|ire|i|e|a|o)$/u', '', $parola);
    }
}
La frase “Richiedere il rimborso di un pagamento addebitato due volte” diventa richied | rimbors | pagament | addebit | due | volt. Le radici non sono parole vere, ma non importa: contano solo come etichette coerenti. Per un’applicazione seria conviene uno stemmer completo per l’italiano (l’algoritmo Snowball, disponibile anche in PHP) o la lemmatizzazione; la versione qui sopra mostra il principio.
L’indice
Rappresentiamo i vettori come array associativi sparsi (termine → peso), che contengono soltanto i termini presenti. Un vocabolario reale ha decine di migliaia di termini, ma un documento ne usa poche decine: memorizzare tutti gli zeri sarebbe uno spreco enorme. È uno dei rari casi in cui gli array di PHP, flessibili e indicizzati per chiave, sono esattamente lo strumento giusto.
final class IndiceTfIdf
{
    /** @var array<int|string, array<string, float>> vettori TF-IDF normalizzati dei documenti */
    private array $vettori = [];

    /** @var array<string, float> */
    private array $idf = [];

    /** @param array<int|string, string> $documenti */
    public function __construct(private readonly Tokenizzatore $tokenizzatore, array $documenti)
    {
        $conteggi = [];
        $df = [];

        foreach ($documenti as $id => $testo) {
            $conteggi[$id] = array_count_values($this->tokenizzatore->tokenizza($testo));
            foreach (array_keys($conteggi[$id]) as $termine) {
                $df[$termine] = ($df[$termine] ?? 0) + 1;
            }
        }

        $n = count($documenti);
        foreach ($df as $termine => $quanti) {
            // IDF "smussato": evita divisioni per zero e valori negativi
            $this->idf[$termine] = log((1 + $n) / (1 + $quanti)) + 1;
        }

        foreach ($conteggi as $id => $tf) {
            $this->vettori[$id] = $this->pesa($tf);
        }
    }

    /** @return list<array{id: int|string, punteggio: float}> */
    public function cerca(string $query, int $quanti = 3, float $sogliaMinima = 0.05): array
    {
        $q = $this->pesa(array_count_values($this->tokenizzatore->tokenizza($query)));

        $risultati = [];
        foreach ($this->vettori as $id => $v) {
            $punteggio = self::prodottoScalare($q, $v); // i vettori sono già normalizzati
            if ($punteggio >= $sogliaMinima) {
                $risultati[] = ['id' => $id, 'punteggio' => $punteggio];
            }
        }

        usort($risultati, fn (array $a, array $b): int => $b['punteggio'] <=> $a['punteggio']);

        return array_slice($risultati, 0, $quanti);
    }

    /** @return array<string, float> i termini più caratterizzanti di un documento */
    public function terminiChiave(int|string $id, int $quanti = 5): array
    {
        $v = $this->vettori[$id];
        arsort($v);

        return array_slice($v, 0, $quanti, true);
    }

    /**
     * @param array<string, int> $tf conteggi dei termini
     * @return array<string, float> vettore sparso TF-IDF con norma 1
     */
    private function pesa(array $tf): array
    {
        $v = [];
        foreach ($tf as $termine => $conteggio) {
            if (isset($this->idf[$termine])) { // termini mai visti nell'indice vengono ignorati
                $v[$termine] = $conteggio * $this->idf[$termine];
            }
        }

        $norma = sqrt(array_sum(array_map(fn (float $x): float => $x * $x, $v)));

        return $norma > 0 ? array_map(fn (float $x): float => $x / $norma, $v) : [];
    }

    /** @param array<string, float> $a @param array<string, float> $b */
    private static function prodottoScalare(array $a, array $b): float
    {
        if (count($a) > count($b)) {
            [$a, $b] = [$b, $a]; // si itera sul vettore più corto
        }

        $somma = 0.0;
        foreach ($a as $termine => $peso) {
            if (isset($b[$termine])) {
                $somma += $peso * $b[$termine];
            }
        }

        return $somma;
    }
}
Alcuni dettagli: poiché tutti i vettori sono normalizzati, il coseno si riduce a un prodotto scalare; il prodotto scorre il vettore più corto e cerca le corrispondenze nell’altro, quindi costa quanto il numero di termini della domanda, non del vocabolario; i termini della domanda che non compaiono in alcun documento vengono ignorati, perché non possono contribuire alla somiglianza.
Un motore di ricerca per le FAQ
$faq = [
    1 => 'Come reimpostare la password dimenticata del proprio account',
    2 => 'Attivare l\'autenticazione a due fattori per proteggere l\'account',
    3 => 'Scaricare la fattura mensile in formato PDF dall\'area clienti',
    4 => 'Modificare il metodo di pagamento con una nuova carta di credito',
    5 => 'Richiedere il rimborso di un pagamento addebitato due volte',
    6 => 'Configurare il server SMTP per l\'invio delle email',
    7 => 'Le email inviate finiscono nella cartella spam dei destinatari',
    8 => 'Aggiungere nuovi utenti al proprio piano aziendale',
];

$indice = new IndiceTfIdf(new Tokenizzatore(), $faq);

foreach ($indice->cerca('mi avete addebitato due volte il pagamento') as ['id' => $id, 'punteggio' => $p]) {
    printf("%.3f  [%d] %s\n", $p, $id, $faq[$id]);
}
Ecco i risultati reali per quattro domande:
« ho dimenticato la password »
   0.674  [1] Come reimpostare la password dimenticata del proprio account

« mi avete addebitato due volte il pagamento »
   0.794  [5] Richiedere il rimborso di un pagamento addebitato due volte
   0.164  [2] Attivare l'autenticazione a due fattori per proteggere l'account
   0.164  [4] Modificare il metodo di pagamento con una nuova carta di credito

« le mie email finiscono nello spam »
   0.707  [7] Le email inviate finiscono nella cartella spam dei destinatari
   0.204  [6] Configurare il server SMTP per l'invio delle email

« non ricordo le credenziali di accesso »
   (nessun risultato)
Le prime tre domande trovano subito la FAQ giusta, con un distacco netto dagli altri risultati. Nella prima la riduzione delle desinenze fa la differenza: “dimenticato” nella domanda e “dimenticata” nella FAQ hanno la stessa radice. Nella seconda si vede un piccolo effetto collaterale: “due” fa salire la FAQ sull’autenticazione “a due fattori”, ma con un punteggio basso. È la soglia minima, insieme al numero massimo di risultati, a governare quanto “rumore” mostrare.
La quarta domanda è la più istruttiva. Chiede esattamente la stessa cosa della prima, ma con parole diverse: “ricordo” invece di “dimenticato”, “credenziali” invece di “password”. TF-IDF non trova nulla, perché non conosce il significato delle parole, solo la loro forma. È il limite strutturale di tutti i metodi basati sul conteggio, ed è esattamente il problema che gli embeddings neurali risolvono.
Il metodo terminiChiave() offre un altro uso: estrarre le parole più caratterizzanti di un documento. Per la FAQ sul rimborso restituisce richied, rimbors, addebit, volt, pagament: un primo passo verso l’etichettatura automatica dei contenuti.
Prestazioni
Su un archivio sintetico di 10.000 documenti di 40 parole ciascuno, con un vocabolario di 3.000 termini, l’indicizzazione in PHP 8.3 ha richiesto circa 310 millisecondi, una ricerca circa 2 millisecondi, con un picco di memoria di 76 MB. Per un archivio di FAQ, una knowledge base aziendale o un catalogo di qualche decina di migliaia di prodotti è più che sufficiente, e l’indice si può calcolare una volta e salvare in cache.
Per archivi molto più grandi il passo successivo è un indice invertito: per ogni termine, l’elenco dei documenti che lo contengono. La ricerca esamina allora solo i documenti che condividono almeno un termine con la domanda, invece di scorrerli tutti. È ciò che fanno, con molte ottimizzazioni in più, i motori di ricerca full-text. La loro funzione di punteggio predefinita, BM25, è una discendente diretta di TF-IDF.
TF-IDF o embeddings?
| Aspetto | TF-IDF | Embeddings neurali |
|---|---|---|
| Sinonimi e parafrasi | Non li riconosce | Li riconosce |
| Termini tecnici, codici, nomi propri | Molto preciso | A volte li “annacqua” |
| Spiegabilità | Totale: si vede quali parole contano | Bassa |
| Risorse | PHP puro, millisecondi, nessun modello | Un modello da caricare e memoria |
| Lingue | Serve un tokenizzatore per ogni lingua | Modelli multilingue pronti |
Non si tratta di scegliere una volta per tutte. Molti sistemi moderni usano una ricerca ibrida: combinano i punteggi di un metodo lessicale come TF-IDF o BM25 con quelli di una ricerca semantica basata su embeddings. Il primo garantisce precisione sui termini esatti (un codice di errore, il nome di un prodotto), la seconda copre i sinonimi e le domande formulate in modo diverso.
Conclusione
Bag of Words e TF-IDF sono tra gli algoritmi più semplici dell’elaborazione del linguaggio, e proprio per questo tra i più utili da conoscere. In meno di cento righe di PHP, senza dipendenze, si ottiene un motore di ricerca veloce, comprensibile e sorprendentemente efficace finché le domande usano le stesse parole dei documenti. Capire dove si ferma aiuta anche a capire perché sono nati gli embeddings, e quando conviene davvero usarli.
Nella prossima parte cambieremo completamente scala: dagli algoritmi agli agenti, i sistemi in cui un modello linguistico non si limita a rispondere ma decide quali strumenti usare per portare a termine un compito, e vedremo quali strumenti offre oggi l’ecosistema PHP.
Serie “PHP e intelligenza artificiale” – parte 6 di 8.
← Parte precedente: Dagli array alla GPU: l’ecosistema ML di PHP
Parte successiva: Agenti AI in PHP →