Un modello linguistico generico sa moltissime cose, ma non conosce le procedure della tua azienda, i manuali del tuo prodotto o i regolamenti interni del tuo ufficio. E quando non sa, tende a inventare con grande sicurezza. La tecnica più diffusa per colmare questo vuoto si chiama Retrieval-Augmented Generation (RAG): prima di rispondere, il sistema cerca nei tuoi documenti i passaggi pertinenti e li fornisce al modello come contesto.
Nella prima parte di questa serie abbiamo affiancato a PHP un servizio Python per riconoscere le entità nei testi. Questa volta restiamo interamente in PHP: costruiremo un assistente che risponde alle domande dei dipendenti sulle procedure interne usando Neuron AI, un framework PHP open source (licenza MIT) per agenti e RAG. Gli esempi sono scritti per la serie 3.x del framework e richiedono PHP 8.1 o superiore.
Perché RAG e non “addestrare il modello”
Davanti al problema “il modello non conosce i miei dati”, la prima idea è spesso il fine-tuning: riaddestrare il modello sui propri documenti. Per rispondere a domande su contenuti specifici, però, il RAG è quasi sempre la scelta migliore:
- Aggiornamento immediato: se una procedura cambia, basta reindicizzare il documento. Con il fine-tuning bisognerebbe riaddestrare.
- Tracciabilità: la risposta si basa su frammenti precisi, che si possono citare e verificare.
- Costi e competenze: non servono GPU né dataset di addestramento.
- Controllo degli accessi: si può decidere quali documenti mettere a disposizione di quali utenti, cosa impossibile una volta che le informazioni sono “dentro” il modello.
Il fine-tuning resta utile per insegnare al modello uno stile o un formato di risposta, non per insegnargli dei fatti.
Come funziona
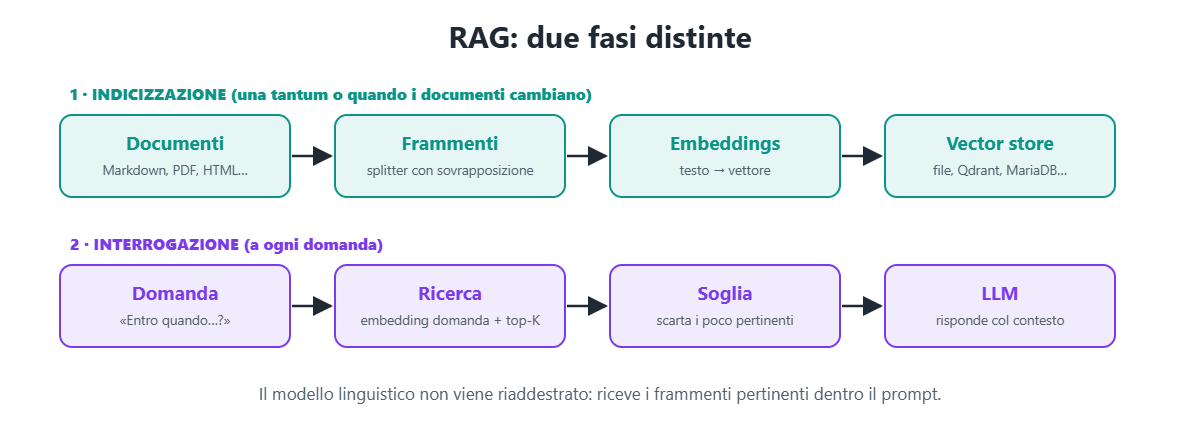
Il cuore del RAG sono gli embeddings: vettori di centinaia o migliaia di numeri che rappresentano il significato di un testo. Testi con significato simile producono vettori vicini, anche se usano parole diverse: “rimborso del pranzo” e “spese per i pasti” finiscono nella stessa zona dello spazio. La vicinanza si misura di solito con la similarità del coseno.
Il sistema lavora in due fasi. Nell’indicizzazione i documenti vengono divisi in frammenti, ogni frammento viene trasformato in un vettore e i vettori vengono salvati in un vector store. Nell’interrogazione la domanda viene trasformata in vettore con lo stesso modello, si cercano i frammenti più vicini e li si inserisce nel prompt insieme alla domanda. Il modello linguistico risponde basandosi su quel contesto.
Le scelte di partenza
Servono tre componenti: un modello linguistico che scrive la risposta, un modello di embedding che produce i vettori e un vector store che li conserva. Neuron AI li astrae dietro interfacce, quindi si possono sostituire senza toccare il resto del codice.
Per questo esempio usiamo modelli eseguiti in locale con Ollama: i documenti interni non lasciano mai la nostra infrastruttura, e per procedure, regolamenti e contratti è un argomento decisivo. Le alternative cloud (OpenAI, Anthropic, Mistral, Gemini e altre) si configurano allo stesso modo cambiando poche righe.
# modello linguistico e modello di embedding, eseguiti in locale
ollama pull llama3.1:8b
ollama pull nomic-embed-text

# il framework
composer require neuron-core/neuron-ai
Come vector store usiamo il FileVectorStore di Neuron AI, che salva i vettori su file: non richiede alcun servizio aggiuntivo ed è adatto fino a qualche migliaio di frammenti. Per volumi maggiori il framework supporta database vettoriali dedicati.
La base di conoscenza
I documenti sono semplici file Markdown in una cartella kb/. Ad esempio kb/rimborsi-spese.md:
# Rimborsi spese di trasferta

Le spese di trasferta vengono rimborsate solo se accompagnate da giustificativo fiscale.
La nota spese va caricata nel gestionale entro 30 giorni dalla fine della trasferta.
Il limite per i pasti è di 35 euro al giorno in Italia e 50 euro al giorno all'estero.
L'uso dell'auto propria va autorizzato prima della partenza e viene rimborsato a 0,30 euro al chilometro.
Nella stessa cartella mettiamo altri documenti (ferie e permessi, accesso remoto alla rete aziendale e così via). La qualità delle risposte dipende soprattutto dalla qualità dei documenti: testi chiari, aggiornati e non contraddittori valgono più di qualunque ottimizzazione tecnica.
La classe RAG
In Neuron AI un sistema RAG è una classe che estende NeuronAI\RAG\RAG e dichiara i propri componenti attraverso alcuni metodi:
<?php

declare(strict_types=1);

namespace App\Ai;

use NeuronAI\Agent\SystemPrompt;
use NeuronAI\Providers\AIProviderInterface;
use NeuronAI\Providers\Ollama\Ollama;
use NeuronAI\RAG\Embeddings\EmbeddingsProviderInterface;
use NeuronAI\RAG\Embeddings\OllamaEmbeddingsProvider;
use NeuronAI\RAG\PostProcessor\FixedThresholdPostProcessor;
use NeuronAI\RAG\RAG;
use NeuronAI\RAG\VectorStore\FileVectorStore;
use NeuronAI\RAG\VectorStore\VectorStoreInterface;

class AssistenteProcedure extends RAG
{
    protected function provider(): AIProviderInterface
    {
        return new Ollama(
            url: 'http://localhost:11434/api',
            model: 'llama3.1:8b',
        );
    }

    protected function embeddings(): EmbeddingsProviderInterface
    {
        return new OllamaEmbeddingsProvider(model: 'nomic-embed-text');
    }

    protected function vectorStore(): VectorStoreInterface
    {
        return new FileVectorStore(
            directory: __DIR__ . '/../var/vettori',
            topK: 3,
            name: 'procedure',
        );
    }

    protected function postProcessors(): array
    {
        // scarta i frammenti poco simili alla domanda (soglia da calibrare sui propri dati)
        return [new FixedThresholdPostProcessor(threshold: 0.3)];
    }

    protected function instructions(): string
    {
        return (string) new SystemPrompt(
            background: [
                'Sei l\'assistente interno che risponde alle domande dei dipendenti sulle procedure aziendali.',
            ],
            steps: [
                'Usa esclusivamente le informazioni contenute nel contesto fornito.',
                'Se il contesto non contiene la risposta, dichiara di non saperlo e suggerisci di contattare l\'ufficio competente.',
            ],
            output: [
                'Rispondi in italiano, in modo sintetico.',
                'Indica sempre il nome del documento da cui hai tratto la risposta.',
            ],
        );
    }
}
Le istruzioni sono la parte più importante. Chiedere esplicitamente di usare solo il contesto, di ammettere quando non si conosce la risposta e di citare la fonte riduce drasticamente le risposte inventate. La classe SystemPrompt le organizza in sezioni (contesto, passi, formato dell’output) che il framework converte nel prompt di sistema.
Indicizzare i documenti
Lo script di indicizzazione carica i file, li divide in frammenti e li passa alla classe RAG, che calcola gli embeddings e li salva nel vector store:
<?php

declare(strict_types=1);

require __DIR__ . '/vendor/autoload.php';

use App\Ai\AssistenteProcedure;
use NeuronAI\RAG\DataLoader\FileDataLoader;
use NeuronAI\RAG\Splitter\SentenceTextSplitter;

$documenti = FileDataLoader::for(__DIR__ . '/kb')
    ->withSplitter(new SentenceTextSplitter(maxWords: 120, overlapWords: 20))
    ->getDocuments();

AssistenteProcedure::make()->addDocuments($documenti);

printf("Indicizzati %d frammenti\n", count($documenti));
La divisione in frammenti (chunking) è una delle scelte che incidono di più sulla qualità. Frammenti troppo lunghi mescolano argomenti diversi e diluiscono il significato; troppo corti perdono il contesto. Lo SentenceTextSplitter taglia rispettando i confini delle frasi; la sovrapposizione (overlapWords) ripete le ultime parole di un frammento all’inizio del successivo, così un’informazione a cavallo del taglio non va persa. Ogni frammento conserva il nome del file di origine, che useremo per citare le fonti.
Quando un documento cambia, il framework offre il metodo reindexBySource(), che sostituisce i frammenti di quella fonte invece di aggiungerne di duplicati.
Fare domande
<?php

declare(strict_types=1);

require __DIR__ . '/vendor/autoload.php';

use App\Ai\AssistenteProcedure;
use NeuronAI\Chat\Messages\UserMessage;

$domanda = $argv[1] ?? 'Entro quando devo caricare la nota spese?';

$risposta = AssistenteProcedure::make()
    ->chat(new UserMessage($domanda))
    ->getMessage();

echo $risposta->getContent(), PHP_EOL;
Per capire davvero cosa succede è utile guardare il prompt che arriva al modello. Neuron AI aggiunge al prompt di sistema i frammenti recuperati, racchiusi in un blocco <EXTRA-CONTEXT> che riporta per ciascuno tipo e nome della fonte. Per la domanda sulla nota spese, il modello riceve qualcosa di questo genere:
# IDENTITY AND PURPOSE
Sei l'assistente interno che risponde alle domande dei dipendenti sulle procedure aziendali.

# INTERNAL ASSISTANT STEPS
Usa esclusivamente le informazioni contenute nel contesto fornito.
Se il contesto non contiene la risposta, dichiara di non saperlo e suggerisci di contattare l'ufficio competente.

# OUTPUT INSTRUCTIONS
 - Rispondi in italiano, in modo sintetico.
 - Indica sempre il nome del documento da cui hai tratto la risposta.

<EXTRA-CONTEXT>Source Type: files
Source Name: rimborsi-spese.md
Content: # Rimborsi spese di trasferta Le spese di trasferta vengono rimborsate solo se accompagnate
da giustificativo fiscale. La nota spese va caricata nel gestionale entro 30 giorni dalla fine
della trasferta. [...]
Non c’è nessuna magia: il modello riceve le istruzioni, il testo pertinente e la domanda. Tutto il lavoro del RAG sta nel portare nel prompt i frammenti giusti.
La soglia di similarità
Con topK: 3 il vector store restituisce sempre i tre frammenti più vicini, anche quando due di questi c’entrano poco. In una prova sulla domanda relativa alla nota spese, i tre frammenti recuperati avevano punteggi di similarità di 0,45 (rimborsi spese), 0,10 (ferie e permessi) e 0,06 (accesso remoto). Passare al modello anche gli ultimi due non aiuta: consuma token, rallenta la risposta e aumenta il rischio che il modello mescoli informazioni non pertinenti.
Per questo la classe definisce un post-processore FixedThresholdPostProcessor, che scarta i frammenti sotto una soglia minima. Con la soglia attiva, nel contesto finisce soltanto il documento sui rimborsi. Il valore giusto va però calibrato sul proprio modello di embedding: ogni modello distribuisce i punteggi in modo diverso, e una soglia valida per uno può essere troppo severa o troppo permissiva per un altro. Il framework offre anche una variante adattiva, che calcola la soglia in base alla distribuzione dei punteggi di ogni ricerca.
Testare senza chiamare il modello
Un sistema RAG va testato come qualunque altro componente. Neuron AI include provider “finti” che permettono di verificare il flusso senza contattare un modello reale: risposte predefinite, embeddings deterministici e la registrazione delle richieste inviate. Questo test verifica che il frammento indicizzato arrivi effettivamente nel prompt:
<?php

declare(strict_types=1);

namespace App\Tests;

use App\Ai\AssistenteProcedure;
use NeuronAI\Chat\Messages\AssistantMessage;
use NeuronAI\Chat\Messages\UserMessage;
use NeuronAI\Providers\AIProviderInterface;
use NeuronAI\RAG\Document;
use NeuronAI\RAG\Embeddings\EmbeddingsProviderInterface;
use NeuronAI\RAG\VectorStore\MemoryVectorStore;
use NeuronAI\RAG\VectorStore\VectorStoreInterface;
use NeuronAI\Testing\FakeAIProvider;
use NeuronAI\Testing\FakeEmbeddingsProvider;
use PHPUnit\Framework\TestCase;

final class AssistenteProcedureTest extends TestCase
{
    public function testIlContestoRecuperatoArrivaAlModello(): void
    {
        $fake = new FakeAIProvider(new AssistantMessage('Entro 30 giorni (rimborsi-spese.md).'));
        $memoria = new MemoryVectorStore();

        $assistente = new class ($fake, $memoria) extends AssistenteProcedure {
            public function __construct(private FakeAIProvider $fakeProvider, private MemoryVectorStore $memoria)
            {
                parent::__construct();
            }

            protected function provider(): AIProviderInterface { return $this->fakeProvider; }
            protected function embeddings(): EmbeddingsProviderInterface { return new FakeEmbeddingsProvider(); }
            protected function vectorStore(): VectorStoreInterface { return $this->memoria; }
            protected function postProcessors(): array { return []; }
        };

        $documento = new Document('La nota spese va caricata entro 30 giorni dalla fine della trasferta.');
        $documento->sourceName = 'rimborsi-spese.md';
        $assistente->addDocuments([$documento]);

        $risposta = $assistente->chat(new UserMessage('Entro quando va caricata la nota spese?'))->getMessage();

        self::assertSame('Entro 30 giorni (rimborsi-spese.md).', $risposta->getContent());
        $fake->assertCallCount(1);
        $fake->assertSent(fn ($richiesta) => str_contains($richiesta->systemPrompt, 'Source Name: rimborsi-spese.md'));
    }
}
Un dettaglio che fa perdere tempo: se si sovrascrive il costruttore di una classe RAG bisogna chiamare parent::__construct(), perché la classe base inizializza il proprio motore di esecuzione nel costruttore.
Questo tipo di test verifica il collegamento tra i componenti, non la qualità delle risposte. Per quella serve una valutazione separata: un elenco di domande con le risposte attese, da rieseguire ogni volta che si cambiano documenti, modelli, frammentazione o soglia.
Verso la produzione
- Vector store dedicato. Oltre qualche migliaio di frammenti conviene un database vettoriale (Qdrant, Elasticsearch, Meilisearch, o MariaDB con il supporto ai vettori), per cui Neuron AI fornisce adattatori pronti.
- Permessi sui documenti. Se non tutti possono vedere tutto, il controllo va fatto prima della ricerca, filtrando i frammenti per ruolo o reparto. Un documento riservato recuperato per sbaglio finisce nella risposta.
- Cronologia della conversazione. Per un vero assistente conversazionale il framework gestisce la memoria dei messaggi precedenti, con diversi meccanismi di persistenza.
- Osservabilità. Registrare domande, frammenti recuperati, punteggi e tempi di risposta è indispensabile per capire perché una risposta è sbagliata.
- Dati personali. Anche con modelli locali, una base di conoscenza che contiene dati personali resta un trattamento da governare: minimizzazione, tempi di conservazione, accessi.
Conclusione
Con un framework come Neuron AI, un sistema RAG in PHP si costruisce con una classe, due script e una cartella di documenti. Il codice è la parte facile. Le decisioni che contano davvero sono la qualità dei documenti, la divisione in frammenti, la soglia di similarità e istruzioni chiare al modello. A quelle va dedicato il tempo.
Nella prossima parte faremo un passo indietro per guardare il quadro d’insieme: cosa significa usare l’intelligenza artificiale in PHP senza Python e senza essere data scientist, e quali problemi si possono risolvere direttamente nel linguaggio che già conosciamo.
Serie “PHP e intelligenza artificiale” – parte 2 di 8.
← Parte precedente: Riconoscere persone, luoghi e aziende nei testi (NER)
Parte successiva: Machine learning in PHP, senza Python →